
Как обучают нейросеть и почему она не знает сегодняшние новости

Обозреватель: как устроен ИИ
Содержание
12 июня 2017 года восемь исследователей выложили на arXiv статью с сухим названием «Attention Is All You Need». В ней была схема, которую потом взяли почти все большие языковые модели: трансформер, сеть из одного внимания, без рекуррентности и без свёрток. На переводе WMT 2014 она набрала 28,4 BLEU с английского на немецкий и 41,8 BLEU с английского на французский, а училась 3,5 дня на восьми видеокартах. С той статьи прошло больше девяти лет. 1 ноября 2026 года свежая модель по-прежнему может уверенно рассказать про ту работу и так же уверенно промахнуться в новости, которая вышла вчера. Причина одна и та же: обучение кончается в конкретный день, и после этого числа внутри модели уже не двигаются. В чате GPThub к ноябрю 2026 года открыты готовые модели, среди них Claude Sonnet 5, Gemini 3.8 Flash и DeepSeek V4 Flash. У каждой своя дата, до которой разработчик собрал тексты. Сегодняшний выпуск газеты в эти тексты не входит.
Откуда взялась привычка ждать от модели свежую сводку
Для понимания даты среза полезно отступить к той статье 2017 года. Трансформер тогда учили на готовых парах предложений для машинного перевода. Корпус собрали заранее, перемешали и гоняли по нему сеть, пока ошибка на отложенной части не переставала падать. Новость, вышедшая на второй день этих 3,5 суток, в пары предложений уже не попадала. Её просто не было в файле.
Позже корпуса стали шире. В них кладут книги, код, справочники, форумы, куски сайтов. Снаружи это похоже на человека, который «прочитал весь интернет и поэтому в курсе». Аналогия с чтением ломается в одном месте. Читатель может вечером открыть ленту и добавить к памяти сегодняшний заголовок. У обученной модели такого вечера нет. Её «память» — это веса, то есть числа, подобранные один раз. Лента после дня заморозки в эти числа не дописывается.
Отсюда и странные ответы про новости. Модель не притворяется архивом нарочно. Она делает то, чему её учили на корпусе: продолжает текст так, как похожие тексты продолжались до среза. Если вопрос звучит как сводка, продолжение тоже звучит как сводка. Факта за сегодня в продолжении может не оказаться. Тон при этом останется спокойным. Увы, спокойный тон люди читают как осведомлённость.
Дата среза и дата выпуска модели живут в разных календарях. Модель могут дописывать, проверять и выпускать месяцами после того, как сбор текстов остановили. Поэтому в ноябре 2026 года в карточке GPT-6 Astra стоит срез 30 апреля 2026 года, хотя сама карточка на сайте разработчика уже описывает готовую модель. Апрельский день здесь не опечатка и не лень редакции. Это граница файла, на котором остановили подбор чисел.
Что такое обучение нейросети
Что такое нейросеть вообще, разобрано в отдельной статье, машинное обучение в целом — в материале про машинное обучение, устройство больших языковых моделей — в статье о LLM. Здесь только этапы обучения и календарь.
Параметр — одно число внутри сети, его как раз и подбирают. Веса — весь набор таких чисел вместе. Токен — кусок текста, буква, слог или короткое слово, с которым сеть делает один шаг. Окно контекста — сколько токенов модель держит в одном вопросе: сам вопрос, вложенный файл и уже написанный кусок ответа. Дата среза знаний — последний период, за который разработчик считает знания модели надёжными. У разных лабораторий формулировка чуть разная, смысл один. Позже этой отметки события в веса не клали.
Общая схема держится на двух проходах, и у разных компаний второй проход устроен по-своему. Сначала сеть читает корпус и учится предсказывать следующий токен. Ошиблась — числа чуть сдвигают, чтобы в похожем месте промах был меньше. Этот проход даёт язык, факты, которые часто повторялись, и привычку к чужим стилям. Сам по себе он не учит коротко отвечать на вопрос. Большая сеть после первого прохода охотно продолжает абзац, а не выполняет просьбу.
Второй проход как раз про просьбу. 4 марта 2022 года группа OpenAI описала его на примере InstructGPT. Сначала люди написали, как должен выглядеть хороший ответ, и на этих примерах дообучили GPT-3 обычным обучением с учителем. Затем те же люди расставили ответы модели по качеству, и сеть доучили обучением с подкреплением по этой расстановке. В оценке людей ответы InstructGPT с 1,3 миллиарда параметров понравились больше, чем ответы GPT-3 со 175 миллиардами, хотя параметров у меньшей модели примерно в сто раз меньше. Размер корпуса сам по себе намерение человека не ловит. Ловит второй проход, где есть образец и сравнение.
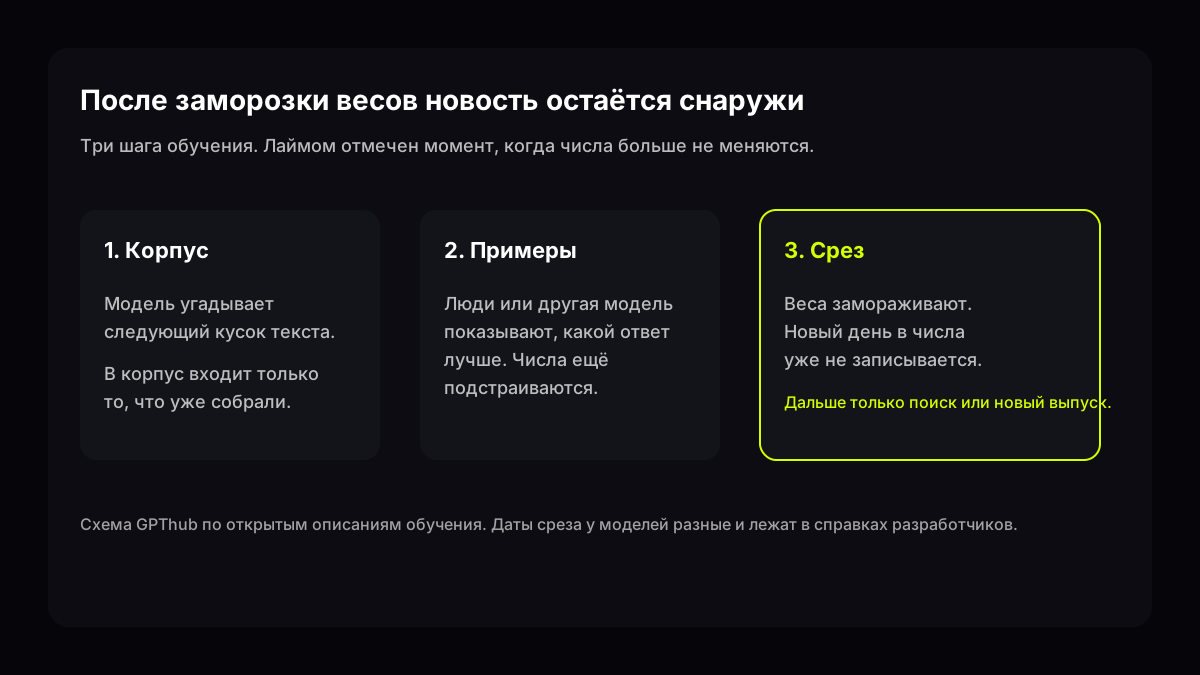
Источник: схема GPThub по статье InstructGPT (4 марта 2022) и справкам о дате среза, сверено 1 ноября 2026
У Anthropic второй проход со временем сдвинулся от живых оценщиков к письменному своду правил. В описании Constitutional AI 2023 года ход такой. На первом этапе модель критикует и переписывает свои ответы по набору принципов. На втором этапе обучение с подкреплением выбирает более безвредный вариант, и оценку даёт тоже модель, без человеческой разметки безвредности. Все принципы сразу на каждом шаге не используются, но каждый встречается за обучение много раз. 21 января 2026 года на той же странице появилась пометка, что опубликована новая версия конституции Claude.
Выходит, что «обучить нейросеть» в новостях про большие модели почти никогда не значит нажать одну кнопку. Сначала корпус и долгий подбор чисел, потом отдельная полировка на примерах и сравнениях, и только затем заморозка.
Как обучают нейросеть на чужих текстах
Прежде всего сеть не получает список фактов столбиком. Она получает последовательности токенов и задание угадать продолжение. Если в корпусе тысячу раз встретилось, что после названия статьи 2017 года идёт список авторов, сеть запоминает эту связь как удобное продолжение. Если событие встретилось дважды и в разных формулировках, связь слабая. Если событие не встретилось ни разу, продолжение модель соберёт из похожих по звучанию абзацев. Отсюда выдуманные даты у редких имён. Сеть не «забыла». Ей не на чем было закрепить число.
Сбор корпуса — отдельная работа, и она заканчивается раньше, чем об этом пишут в карточке. Текст надо скачать, выкинуть дубли, убрать мусор, иногда отфильтровать по языку и качеству. Пока фильтры считаются, календарь идёт дальше. Документ, который выложили в сеть в последний день сборки, может не попасть в файл просто потому, что обход сайтов к нему не дошёл. Поэтому дата среза — не обещание «мы знаем всё до этой полуночи». Это оценка разработчика, до какого месяца знания ещё плотные.
Дальше идёт сам подбор. Один и тот же кусок корпуса модель видит не один раз, ошибку считают на каждом шаге, числа сдвигают крошечными шагами. На переводе 2017 года весь этот цикл уложился в 3,5 дня и восемь видеокарт, потому что задача была узкая, пары предложений. У современных моделей ни OpenAI, ни Anthropic, ни xAI в открытых справках на 1 ноября 2026 года не публикуют такой же короткий рецепт «столько-то дней и столько-то карт» для флагмана. Видно другое. Даже узкий переводной трансформер учился на заранее нарезанном файле, а не на живой ленте.
После первого прохода модель уже «знает» частые факты и при этом плохо слушается. Она может ответить продолжением вопроса, куском кода или чужим постом. InstructGPT как раз чинил это слушание, а не добавлял в GPT-3 вчерашние новости. Примеры хороших ответов тоже собирают заранее. Если в примерах нет сводки за ноябрь 2026 года, второй проход её не создаст. Он учит форме: ответить по делу, не уходить в токсичность, признать границу, когда данных нет. Границу ещё нужно положить в примеры. Если положили плохо, модель заполняет дыру гладким текстом.
Заморозка — третий и скучный шаг, на схеме он отмечен отдельно. Веса записывают, проверяют на отложенных задачах и отдают в продукт. С этого часа модель можно спрашивать сколько угодно. Спрашивание не дописывает числа. Тысяча людей может обсудить с ней одну и ту же новость, и на тысяча первом вопросе веса останутся теми же. Меняется только текст, который положили в окно контекста на этот один раз.
Почему она не знает сегодняшние новости
Ответ на заголовок сидит в заморозке, и его стоит разложить по датам, а не по ощущению «модель тупит». Справки, открытые 1 ноября 2026 года, дают такую картину.
У OpenAI в карточке GPT-6 Astra дата среза — 30 апреля 2026 года. Окно контекста у этой модели 1 050 000 токенов, потолок ответа — 128 000 токенов. Окно большое, и это легко перепутать со свежестью. В окно можно вложить длинный документ, который человек сам принёс. Документ, которого человек не принёс и которого не было в обучении, окно не добывает. Поиск в интернете у GPT-6 Astra в списке инструментов есть, но это отдельный вызов. Он приносит страницы в вопрос. Он не сдвигает дату среза в карточке.
У xAI в обзоре моделей формулировка ещё жёстче. У Grok нет знания текущих событий и данных за пределами обучающей выборки, пока не включены инструменты поиска. Для Grok 4.7 там же указан срез май 2026 года и окно 500 000 токенов. Май уже позади относительно 1 ноября. Всё, что вышло летом и осенью 2026 года, для этой модели — либо находка поиска, либо догадка по старым текстам. Подробности выпуска разобраны в обзоре Grok 4.7. Здесь важен только календарь среза.
У Anthropic справка перечисляет срез поимённо, и список длинный. Claude Haiku 5.5, Claude Sonnet 5.5, Claude Opus 5.5 и Claude Fable 5.1 обучены на данных до июня 2026 года. Claude Opus 5 — до мая 2026 года. Claude Sonnet 5, Claude Fable 5, Claude Opus 4.8 и Claude Opus 4.7 — до января 2026 года. Claude Sonnet 4.6 и Claude Opus 4.6 — до августа 2025 года. Claude Haiku 4.5 — до июля 2025 года. Claude Opus 3 — до августа 2023 года. В той же справке написано прямо. Модели могут не знать событий после своей даты. На вопрос о более свежем ответ бывает неточным. Разбор семейства вокруг Sonnet 5.5 лежит в отдельной статье, карточка Claude Sonnet 5 — на сайте моделей.
| Модель | Дата среза по справке разработчика | Что это значит 1 ноября 2026 |
|---|---|---|
| GPT-6 Astra | 30 апреля 2026 | Летние и осенние новости в веса не входили |
| Grok 4.7 | май 2026 | Без поиска текущих событий нет |
| Claude Opus 5.5, Sonnet 5.5, Haiku 5.5 | июнь 2026 | Июль и позже — уже за границей среза |
| Claude Sonnet 5 | январь 2026 | Срез на полгода раньше, чем у Sonnet 5.5 |
| Claude Opus 3 | август 2023 | Для сегодняшней сводки модель старая |
Причём более новая версия не всегда тащит за собой более поздний срез на много лет вперёд. У Claude Sonnet 5 срез январь 2026 года, у Sonnet 5.5 — июнь 2026 года. Полгода, не «всё до вчера». У старого Opus 3 граница так и осталась в августе 2023 года. Если в чате случайно выбрана старая модель, она честно живёт в своём годе, даже когда рядом в списке стоит модель с июньским срезом.
Поиск эту таблицу не отменяет. Он подмешивает в вопрос текст страниц, которые нашлись сейчас. Ответ тогда опирается на две разные кучи. Одна куча — веса до среза. Вторая — абзацы, которые пришли в окно на этот запрос. Перепутать их легко. Модель может пересказать найденную страницу и тут же дописать деталь из старой памяти, без пометки, где какая куча. Для учебной работы это главное место, где появляются тихие ошибки. Новость вроде есть, а цифра рядом с ней взята из прошлогодней статьи с похожим заголовком.
Есть и обратная путаница. Человек вкладывает в чат свежую заметку и думает, что модель «выучила тему». Заметка лежит в окне, пока идёт этот разговор. В следующем диалоге, если файл не приложить снова, её нет. Окно контекста — это стол, который после ответа освобождают. Веса — это полка, которую заперли в день среза. Стол можно заставить газетами. Полка от этого не пополняется.
Как самому не принять догадку за сводку
Практическая проверка короткая, и она не заменяет поиск по первоисточнику. Берут один и тот же вопрос к модели с известным срезом. Смотрят три следа, а не гладкость абзаца.
Первый след — дата внутри ответа. Если спросить, что произошло 31 октября 2026 года, а у выбранной модели срез в апреле, мае или июне, гладкий рассказ без ссылки уже подозрителен. Надёжный ход модели в таком месте — сказать, что событие позже её данных, либо опереться на принесённый текст. Если вместо этого идут фамилии, счёт и место, их стоит сверить с заметкой издателя, а не с повторным вопросом той же модели. Повтор часто повторяет ту же догадку другими словами.
Второй след — вопрос из учебника против вопроса из ленты. Дата выхода статьи про трансформер, 12 июня 2017 года, и цифры 28,4 и 41,8 BLEU лежат глубоко внутри любого современного среза. На таком вопросе модель обычно держится, потому что о ней написано очень много. Вчерашний локальный матч, назначение министра на прошлой неделе или цена билета на завтра в корпусе 2017 года не встречались и в корпусе апреля 2026 года тоже могли не встретиться. Разница в устойчивости двух ответов как раз и есть дата среза, только её видно на паре вопросов, а не на одном.
Третий след — просьба назвать, откуда взята деталь. Если модель ссылается на страницу, страницу открывают. Если говорит «по свежим данным» и не показывает, каким, перед нами формула из второго прохода обучения. Её учили звучать полезно. Полезный тон и свежий факт совпадают только тогда, когда факт был в корпусе или попал в окно сейчас. В гайде о запросах разобрано, как сузить вопрос. Для новостей сужение выглядит так: назвать день, попросить опору на приложенный текст и запретить достраивать то, чего в тексте нет. Это всё ещё один запрос к замороженным весам, не урок обучения сети.
В чате GPThub тот же приём работает на моделях, которые уже открыты. Имеет смысл начать с сравнения моделей на практике и с короткого гида, какую модель брать. Для новости удобнее модель с более поздним срезом в справке и привычка прикладывать источник самой заметки. Гонка за «самой сильной» здесь мало что решает. Карточка GPT-6 Astra и страница Grok 4.7 расходятся на месяц, справка Claude для линейки 5.5 — ещё на месяц вперёд, до июня. Месяц для вчерашней новости ничего не решает. Все три границы остались позади 1 ноября.
Отдельная ловушка — вопрос «кто выиграл вчера», заданный модели без поиска и без вложенной заметки. Сеть всё равно что-то продолжит. У неё нет режима пустого листа, если его специально не добились примерами второго прохода. Часть моделей после полировки честно пишет, что не знает. Часть заполняет клетку правдоподобным клубом, потому что в корпусе полно спортивных сводок и форма «команда, счёт, стадион» очень устойчива. Форма устойчива именно потому, что её видели миллион раз. Конкретный вчерашний счёт видели ноль раз.
Как обучить нейросеть под свои задачи
Запрос «как самому обучить нейросеть» в поиске обычно значит одну из трёх разных работ, и их путают из-за одного слова «обучить».
Первая работа — собрать сеть с нуля и прогнать через неё свой корпус. Так учили трансформер для перевода в 2017 году, так лаборатории учат большие модели сейчас. Для одного человека это не домашний вечер. Нужны данные, которые есть право использовать, машины, которые считают дни или месяцы, и люди, которые ловят сбои. Открытые справки флагманов на 1 ноября 2026 года такой маршрут для повторения у себя не описывают. Ждать от них пошаговый рецепт бессмысленно. Они описывают уже замороженный продукт и его границу знаний.
Вторая работа — дообучить чужую модель на своих примерах. В карточке GPT-6 Astra пункт дообучения стоит как неподдерживаемый. Это полезное ограничение для ожидания «я допишу в Astra свои лекции, и она станет моей». Через описанную конечную точку разработчик такого пути не даёт. Даже там, где дообучение у какой-то другой модели есть, оно сдвигает стиль и набор примеров. Оно не подписывает модель на завтрашнюю ленту новостей. Свои сто вопросов и ответов учат форме этих ста вопросов. Они не открывают модели глаза на газету, которую вы не положили в файл.
Третья работа — не трогать веса вообще. Человек приносит в окно конспект, методичку или статью и просит ответить только по ним. Для учёбы и для своих задач это основной путь, и он как раз доступен в обычном чате. DeepSeek V4 Flash и Gemini 3.8 Flash уже стоят среди моделей, с которыми так работают. Как устроено семейство DeepSeek и чем один проход обучения отличается от полировки, разобрано в статье про DeepSeek. Про календарь и возможности GPT-6 Astra — в материале про эту модель. Ни там, ни здесь дообучение на коленке не превращает срез в «сегодня».
Свои задачи почти всегда про форму и про ваши документы. Форму большая модель уже получила на втором проходе, документы вы кладёте в окно сами. Новости поверх этого остаются отдельной проблемой календаря. Если документ свежий, модель его видит, потому что он в вопросе. Если документа нет, она видит только полку до среза.
Создать «обучаемую нейросеть» в смысле игрушки на десять примеров можно в учебном курсе по машинному обучению. Такая игрушка показывает, как ошибка двигает числа. Она не отвечает на вопрос про вчерашний закон и не заменяет модель, у которой в справке написан месяц среза. Путать эти две вещи — главный источник разочарования у тех, кто набрал в поиске «как создать обучаемую нейросеть» и ждал, что после выходных получится свой аналог большой модели с живой лентой.
Что будет дальше с границей знаний
Лаборатории не стоят на одной дате навсегда. У каждой выпущенной модели граница своя. Новая версия получает новый срез. Старая остаётся при своём. Поэтому таблица выше устареет, когда выйдет следующая карточка, и не устареет в главном правиле. У выпущенной модели граница есть всегда, и она раньше дня, когда вы открыли чат.
Ждать, что следующий выпуск «будет знать всё до минуты анонса», по прошлым карточкам не приходится. Между 30 апреля у GPT-6 Astra и чтением этой карточки 1 ноября лежит полгода. Между маем у Grok 4.7 и тем же днём — около полугода. Между июнем у Claude 5.5 и ноябрём — четыре месяца. Зазор разный, ноль в открытых справках не встретился. Поиск и вложенный текст остаются способом дотянуть ответ до сегодня, пока кто-то не выложит модель с более поздней границей и не напишет эту границу в своей справке.
Если в ленте пишут, что модель «следит за новостями», лучше открыть строку про дату среза в справке разработчика. Пересказ ленты эту строку не заменяет. Там будет месяц. Месяц и есть обещание. Всё, что позже месяца, либо приехало поиском в этот вопрос, либо придумано из похожих старых абзацев. Третьего кармана у замороженных весов нет.
Вопросы и ответы
Как обучать нейросеть?
Сначала собирают корпус текстов и учат сеть угадывать следующий кусок. Числа внутри сети подстраивают по ошибке. Потом на отдельных примерах и сравнениях ответов учат форму полезного ответа, как в работе InstructGPT от 4 марта 2022 года или в конституционном обучении Claude. В конце числа замораживают. День заморозки и есть причина, по которой сегодняшняя новость в модель не входит.
Как создать обучаемую нейросеть?
Учебная сеть на маленьком файле создаётся в курсе по машинному обучению и годится, чтобы увидеть, как ошибка двигает числа. Большая языковая модель собирается в лаборатории на заранее нарезанном корпусе, не на живой ленте. Для своих текстов обычно хватает уже обученной модели и вложения файла в вопрос. Дообучение GPT-6 Astra разработчик в карточке не поддерживает.
Как работает и как обучать нейросеть, если нужны именно новости?
Работает она как продолжитель текста, который видела до среза, плюс как исполнитель формы ответа после второго прохода. Новости позже среза в веса не попадают. Их приносят поиском, если он у модели включён, или вставляют заметку в вопрос. Без этого модель может написать правдоподобную сводку по привычной форме, и сводка будет мимо факта.
Что такое обучение нейросети простыми словами?
Это подбор чисел, чтобы сеть лучше угадывала продолжение уже собранных текстов, а затем отдельная полировка, чтобы она слушалась просьбы. После полировки числа запирают. Обучение кончается. Дальнейшие вопросы сеть отвечает замороженными числами и тем, что ей положили в окно прямо сейчас.
Как самому обучить нейросеть под свои задачи?
Свои лекции, регламент или подборку статей кладут в вопрос и просят не выходить за этот текст. Это не переучивание весов, зато задача решается на актуальных для вас страницах, хоть от 1 ноября 2026 года. Полный цикл с корпусом и видеокартами для личной задачи не нужен. Если хочется сравнить, какая готовая модель удобнее на вашем тексте, начните с гида по выбору модели.
Как создать и обучить свою нейросеть, чтобы она знала сегодняшний день?
Замороженная сеть знает сегодняшний день только если этот день попал в корпус до среза или если текст про этот день лежит в вопросе. Свой маленький учебный пример сегодняшний день «знает» лишь в тех десяти строках, которые вы сами в него положили. Подписка на ленту новостей внутрь весов из открытых справок больших моделей не следует. Свежесть живёт в поиске и во вложенном файле.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- Vaswani et al. Attention Is All You Need, arXiv:1706.03762, версия от 12 июня 2017
- Ouyang et al. Training language models to follow instructions with human feedback, 4 марта 2022
- Справка Anthropic: насколько свежие данные обучения Claude
- OpenAI, карточка GPT-6 Astra
- xAI, обзор моделей и срез Grok 4.7
- Anthropic, конституция Claude, обновление 21 января 2026
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Спросить модель в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.