"Нейросеть для текста: статьи, посты, письма и правка готового"
Обозреватель: как устроен ИИ
Содержание
14 февраля 2019 года OpenAI показала языковую модель GPT-2 и не стала выкладывать её целиком. Причину компания назвала прямо — опасение, что технологию используют во вред. Среди возможных злоупотреблений в том же тексте перечислены поддельные новости, спам и выдача себя за других людей в сети. Первым образцом в том объявлении шла заметка про единорогов. Человек написал два предложения: учёные нашли в Андах стадо единорогов, которые говорят на чистом английском. Остальное дописала модель, и под текстом честно указано, что вариант выбран из десяти попыток. Нынешняя текстовая нейросеть ведёт диалог, пишет письма и правит чужие абзацы, но устроена по тому же принципу — она дописывает продолжение. Из этого принципа следует почти всё, что нужно знать, если вы берёте её для статьи, поста, письма или правки готового текста.
Что такое текстовая нейросеть
Её часто представляют справочником, в который загрузили весь интернет. Задал вопрос — модель нашла нужную страницу и переписала. Сравнение неверно в главном. Готовых страниц внутри нет, есть числа (параметры), подобранные при обучении так, чтобы лучше угадывать продолжение. GPT-2 учили ровно этому: по всем предыдущим словам предсказать следующее. Обучающий текст занимал 40 ГБ и был собран с 8 млн веб-страниц, параметров у модели было 1,5 млрд. Ближе к правде подсказка следующего слова на клавиатуре телефона, только несравнимо крупнее и обученная на гораздо большем объёме текста.
Собрана GPT-2 на трансформере — архитектуре из статьи «Attention Is All You Need», которую выложили на arXiv 12 июня 2017 года. Как устроен этот чертёж, подробно рассказано в статье про трансформер, а чем большая языковая модель отличается от обычного чат-бота — в разборе про LLM. Для работы с текстом хватит трёх терминов.
Токен — кусок слова, знак препинания или короткое слово целиком. Модель режет текст на такие куски и считает именно в них. Окно контекста — сколько токенов модель видит за один раз: ваш запрос, вложенный файл, прошлые сообщения диалога и уже написанную часть ответа. Лимит ответа — сколько токенов она может выдать за один проход. Всё, что не поместилось в окно, для модели не существует, пока вы снова не вставите нужный фрагмент. Почему один и тот же текст на разных языках режется на разное число токенов и почему модель «забывает» середину длинного файла, объяснено в статье про токены и окно контекста.
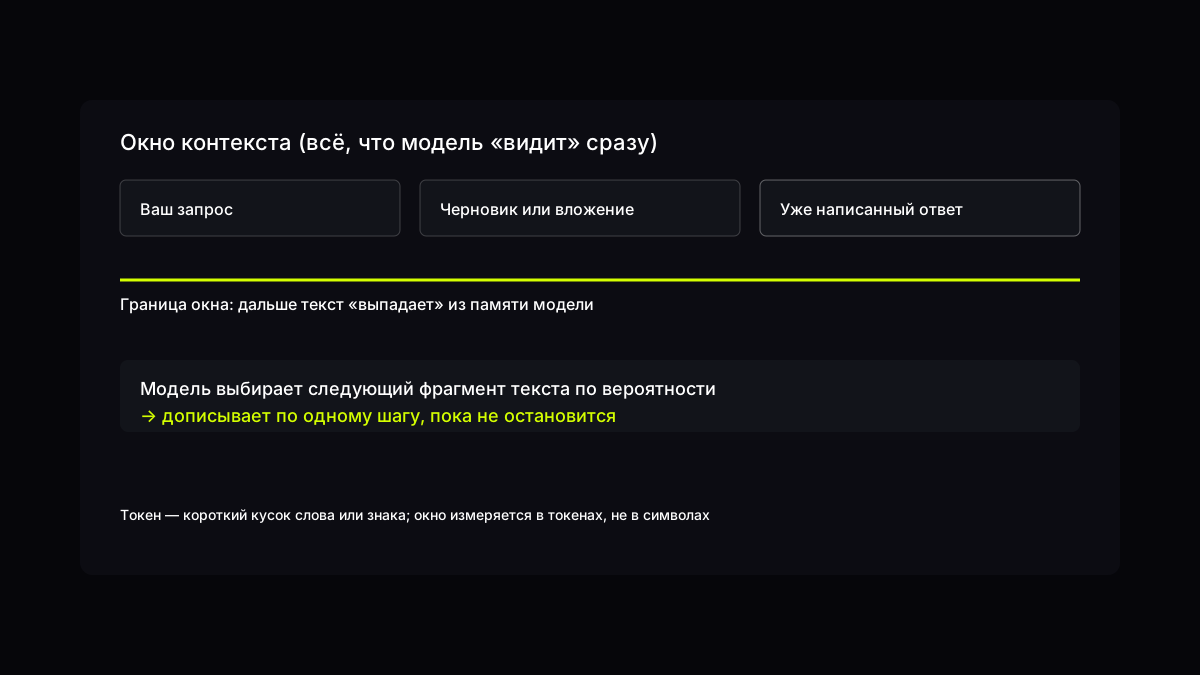
Схема окна контекста, иллюстрация GPThub
Модель для чата получают в два этапа. Сначала её долго учат угадывать продолжение на огромных массивах текста, потом доучивают на диалогах. OpenAI описала второй этап в анонсе ChatGPT 30 ноября 2022 года. Люди-тренеры сами писали образцы диалогов, играя и пользователя, и помощника. Затем они сравнивали несколько вариантов ответа модели и выстраивали их от лучшего к худшему, а модель подстраивали под эти оценки. Метод называется обучением с подкреплением на отзывах людей (RLHF). Он объясняет вежливый тон и готовность взяться за любую просьбу, но базой проверенных фактов модель от этого не становится.
Следствие очень простое: модель сильна там, где хватает языка, — структура, связность, пересказ, смена тона. Слаба она там, где нужна опора на мир: точная дата, номер приказа, цитата из документа, которого не было во входе. Поэтому черновик от нейросети хорош как первая версия и опасен как последняя, если его никто не прочитал.
Чем нейросеть для генерации текста отличается от поиска
Поиск возвращает ссылки, и источник выбираете вы сами. Модель в чате возвращает готовый связный абзац. Экономия времени тут же оборачивается риском: текст звучит так, будто каждую цифру проверили, хотя модель проверяла только правдоподобие.
В том же анонсе ChatGPT OpenAI перечислила ограничения, и список до сих пор читается как памятка редактору. Модель иногда пишет правдоподобные, но неверные или бессмысленные ответы. Она чувствительна к формулировке: на один вариант вопроса говорит, что не знает ответа, а на слегка перефразированный отвечает верно. Она многословна и повторяет одни и те же обороты. Когда запрос неоднозначен, уточнять она не станет и попробует угадать, чего хотел человек.
| Инструмент | Что на выходе | Где ошибка больнее всего |
|---|---|---|
| Поиск | Список страниц | Устаревшая страница в топе выдачи |
| Автозамена | Одно слово | Опечатка остаётся незамеченной |
| Текстовая нейросеть | Связный черновик | Выдуманная дата, имя, ссылка |
С тех пор модели стали заметно сильнее, но этот пункт из списка никуда не делся. В карточке Gemini 3.8 Flash, которую Google опубликовала 2 сентября 2026 года, прямо сказано, что модель может проявлять общие ограничения таких систем, например галлюцинации, то есть выдуманные факты. Откуда они берутся и как их ловить, разобрано в статье о том, почему нейросеть выдумывает. Для работы с текстом из этого следует одно правило: всё, что можно проверить по документу, проверяйте по документу, а не по тому, как гладко звучит абзац.
Как модель собирает абзац
На каждом шаге модель оценивает возможные продолжения из своего словаря токенов и выбирает одно из вероятных, обычно с небольшой долей случайности. Поэтому один и тот же запрос при повторе даёт другой черновик: меняется цепочка выборов, а «знания» остаются прежними. Отсюда и десять попыток под заметкой про единорогов.
Ещё в анонсе GPT-2 OpenAI описала, где такая машина ломается, и список с тех пор мало устарел. Модель повторялась, теряла представление о мире (например, иногда писала о пожарах под водой) и неестественно перескакивала с темы на тему. На темах, о которых в обучающих данных было много текста, — Brexit, «Властелин колец», — приличный результат выходил примерно в половине попыток. На узкой технической или редкой теме модель справлялась плохо.
Нынешние модели несравнимо сильнее GPT-2, но слабое место осталось тем же. Частое модель воспроизводит уверенно, редкое подменяет похожим. Дата регионального события, фамилия специалиста из узкой отрасли, номер пункта в договоре — именно тут появляются правдоподобные подмены. Причём модель не отмечает, где она уверена, а где угадывает: оба куска звучат одинаково ровно.
Канцелярит и одинаковые зачины — тоже следствие этой механики, а не «плохого дня» модели. Она тянется к среднему по множеству текстов, а среднее звучит гладко и безлично. Если нужен узнаваемый голос бренда или автора, смены модели мало: нужны образцы ваших текстов во входе и прямые запреты на шаблонные связки.
В длинном диалоге работает то же окно. Старые сообщения остаются на экране, но в расчёт могут уже не попадать. Вернулись к проекту через неделю — вставьте ключевые факты заново или приложите файл-памятку.
Ещё один рабочий приём для статей и писем — попросить черновик только из коротких предложений, не длиннее двенадцати слов. Так видно, где модель повторила одну мысль дважды разными словами. Потом разрешите длинные фразы точечно — там, где нужна связка.
Статья, пост и письмо: три разных запроса
Просьба «напиши текст» без уточнения жанра даёт усреднённый результат, который не годится ни для одного места публикации.
Статья или заметка
Нужны тема, читатель, объём и опора на факты. Попросите план из пяти–семи блоков, затем разворачивайте каждый блок отдельным сообщением: так проще поймать, где модель начала повторяться. Факты лучше вставлять списком или файлом и не надеяться, что модель «помнит» ваш рынок. Тем, кто пишет книги и длинные циклы, полезнее статья про нейросеть для писателя: там разговор о сюжете и голосе автора, здесь только общая механика.
Пост для соцсети
Нужны площадка, длина, один призыв к действию и запрет на то, чего не было в задании. Без такого запрета модель может дописать «акцию до воскресенья», которой у вас нет. Работа с лентой, картинками и шаблонами разобрана в материале про нейросеть для SMM; здесь достаточно правила: черновик пишется быстро, отвечает за публикацию человек.
Письмо
Укажите адресата, повод и желаемый итог — «согласовать перенос», «вежливо отказать», «напомнить о документе». Попросите два варианта тона, нейтральный и более тёплый, и сравните, не раздулась ли вежливость в пустые фразы. Если у письма есть юридические последствия, его должен прочитать юрист; для обычной переписки черновика модели обычно хватает.
Статья для сайта или блога
Здесь модель часто выдаёт энциклопедический зачин и ровные абзацы одинаковой длины, и такой текст быстро узнаётся. Задайте конкретный угол: «объясни новичку», «разбор для человека, который уже пробовал и разочаровался», «только практические шаги, без истории компании». Добавьте список вопросов, на которые текст обязан ответить, и попросите в конце отметить, какой вопрос остался без ответа. Так пропуски ловятся раньше, чем о них напишут в комментариях.
Сокращение и смена тона
Сократить проще по точному заданию вроде «вот абзац на 400 слов, нужно 120, смысл сохранить, примеры убрать». Попросите перечислить, что модель выкинула, — так видно, не исчез ли важный аргумент. Если текст ваш, приложите его целиком. Если чужой, модель вопрос авторских прав не снимает.
Смена тона — отдельная операция. Не смешивайте её с сокращением в одном сообщении, пока не получите устойчивый результат. Формулировка «сделай официальнее, но без канцелярита» работает лучше, чем «перепиши красиво». Для постов и писем полезно указать, кого нельзя задеть и какие слова бренд не использует.
Без образца модель подставит усреднённый деловой стиль. Поэтому при смене тона приложите один-два своих абзаца, которые уже звучат так, как вам нравится, и напишите: «сохрани строй предложений, убери пассив и канцелярит». Два живых абзаца работают лучше десяти прилагательных про желаемый тон.
Если после правок текст всё равно похож на соседние черновики, причина в общих шаблонах обучения. Признаки такого текста перечислены в статье про похожие тексты нейросети. Практический вывод короче: меняйте зачин, длину предложений и способ подачи фактов, а просьба «сделай уникальнее» почти ничего не даёт.
Пример с сокращением абзаца
Запрос может выглядеть так — «Сократи абзац ниже до 60 слов. Сохрани все три цифры и название компании. Убери вводные обороты и все примеры, кроме первого. После текста отдельным списком перечисли, что ты выкинул». Дальше идёт сам абзац.
Что проверить в ответе. Первое — цифры, все три на месте и не округлены. Второе — название компании написано так же, как в оригинале. Третье — список выкинутого: прочитайте его внимательно, там иногда оказывается главный довод, который модель сочла примером. Ещё полезен приём «две версии рядом»: попросите в одном ответе исходный абзац и сжатый, а повторы между ними удалите сами. Потерю смысла видно только при сравнении, при чтении одной короткой версии её легко пропустить.
Как сгенерировать текст нейросетью без воды
У многословия есть задокументированная причина. В анонсе ChatGPT OpenAI объясняла его перекосом в данных обучения: тренеры предпочитали длинные ответы, которые выглядели полнее. Вторая причина — уже упомянутая манера угадывать вместо того, чтобы переспросить. На размытый запрос модель отвечает общим местом, и запрос из трёх слов «напиши статью про X» почти гарантирует именно его.
Ниже минимальный каркас, который можно держать в заметках и менять под задачу.
- Роль и читатель — «ты редактор для читателя без технического образования» или «ты помощник студента первого курса».
- Формат и объём — «пост на 800 знаков», «письмо на пять предложений», «план статьи без текста».
- Факты — список утверждений, которыми можно пользоваться, и отдельной строкой — что выдумывать нельзя.
- Стиль — «без восклицаний», «без слова „уникальный“», «короткие абзацы».
- Проверка — «в конце перечисли три места, где ты не уверена в фактах».
Подробные шаблоны под разные жанры собраны в гайде с промптами для текстов, а общие правила составления запроса — в гайде «Как писать промпты». Повторять их здесь не будем: эта статья про выбор задачи и контроль результата.
Удобнее держать один диалог на одну задачу. Если смешать в одной ветке договор, пост и сказку для ребёнка, модель начнёт переносить интонации из жанра в жанр. Новый диалог — дешёвый способ обнулить контекст.
Длинный документ по частям
У Gemini 3.8 Flash и Claude Sonnet 5.5 окно по документации разработчиков — около миллиона токенов. Для своих моделей Anthropic оценивает такой объём примерно в 555 тысяч слов. Это не значит, что отчёт на двести страниц стоит вставлять целиком с просьбой «сделай всё сразу»: середина длинного входа теряется чаще начала и конца, и это измеряли отдельно.
Надёжнее разбить документ на части по смыслу — введение, таблица выводов, приложение — и к каждой части дать свой запрос: «сожми до пяти пунктов», «перескажи простым языком», «выпиши только цифры с единицами измерения». Между частями оставляйте перекрытие в два-три абзаца, чтобы модель не потеряла место, где оборвалась мысль. Сверку цифр всё равно делает человек.
Работа с готовым черновиком
Если текст уже есть, модель удобнее как редактор. Попросите «отметь слабые места списком» и правьте точечно. Для письма клиенту хорош двухшаговый приём: сначала «сделай структуру: приветствие, суть, просьба, подпись», потом «заполни блок „суть“ по моим фактам». Так меньше шансов, что модель придумает детали переписки, которой не было.
Какую модель открыть под текст
Окно в миллион токенов теперь есть у многих моделей, поэтому выбирать приходится по другим признакам: скорость, аккуратность правок, характер текста. Для русского черновика удобно держать под рукой три модели.
- Gemini 3.8 Flash. Google выпустила её 2 сентября 2026 года и называет самой умной моделью линейки Flash. Окно — до миллиона токенов, ответ — до 64 тысяч. Подходит для быстрого перебора — заголовки, короткие посты, первый вариант письма. Подробнее — в разборе Gemini 3.8 Flash.
- Claude Sonnet 5.5. Anthropic выпустила её 28 сентября 2026 года и пишет, что сильнее всего она в чётко поставленных повседневных задачах и аккуратных документах. Хороша для длинных текстов и правки чужого абзаца; чем она отличается от предшественницы Claude Sonnet 5, рассказано в статье про Sonnet 5.5.
- DeepSeek V4 Flash. Открытая модель, репозиторий и веса которой выложены под лицензией MIT; окно — миллион токенов. Полезна как второе мнение — тот же запрос, другой характер текста. Устройство семейства объяснено в статье «Что такое DeepSeek».
Все три уже доступны в чате GPThub. Сравнение моделей на живых задачах собрано в гайде «Сравнение моделей на практике», общий порядок выбора — в гайде «Как выбрать модель». Выбор модели не заменяет проверку фактов: другое имя в шапке чата не превращает выдуманную дату в настоящую.
Когда хватит быстрой модели
Короткие форматы — заголовки, пункты для презентации, варианты первого абзаца — редко требуют тяжёлой модели. Здесь важнее скорость перебора и готовность переиграть тон по короткой правке. Если черновик уходит в корзину после первого прочтения, это обычный рабочий цикл.
Когда нужна модель потяжелее
Длинное письмо с осторожными формулировками, пересказ отчёта на двадцать страниц, текст, где каждая оговорка важна, лучше отдать модели, которая держит связность на дистанции. Anthropic в том же анонсе Sonnet 5.5 пишет, что в сложной открытой работе, где нужно долго держать суждение, заметно сильнее остаётся старшая Claude Opus 5.5 — она тоже уже доступна в чате. Перекрёстную проверку цифр человеком это не отменяет.
Что проверять в ответе
Перед тем как отправить текст заказчику, коллеге или в ленту, пройдитесь по короткому списку. Он скучный, зато ловит типичные сбои.
- Имена, даты, цифры. Совпадают ли они с вашим заданием, нет ли красивых чисел без источника.
- Ссылки. Модель иногда придумывает адрес, который открывается с ошибкой 404. Откройте каждую.
- Повторы. Одинаковый зачин в соседних абзацах — признак шаблона.
- Тон. Не появились ли назидательные фразы и оговорки, которых не было в запросе.
- Объём. Не раздулась ли вода ради видимости полноты.
Пример с письмом о переносе встречи
Допустим, нужно написать коллеге, что совещание сдвигается на четверг. Плохой запрос — «напиши письмо о переносе». Хороший — «письмо коллеге из IT-отдела, переносим созвон с двух часов дня во вторник на одиннадцать утра в четверг, причина — накладка с заказчиком, тон нейтральный, без извинений на полстраницы, до 700 знаков, не выдумывай имена участников». В ответе проверьте три места: день недели, время и нет ли обещаний, которых вы не давали. Проверка занимает минуту и ловит типичную ошибку — правильный тон с выдуманной деталью в середине.
Ошибки, которые видны сразу
- Вера ссылке на исследование. Модель уверенно пишет «исследование 2024 года показало» и не называет, какое именно. Без ссылки это декорация, а не факт.
- Один запрос на всё. Статья, блок для поиска, письмо клиенту и раздел вопросов в одном сообщении дают кашу жанров.
- Бесконечные «улучши». После третьей просьбы «сделай лучше» текст часто становится одинаково гладким и пустым. Полезнее назвать, что именно не так: «убери второй абзац», «замени пример».
- Документ без разбиения. Длинный договор одним куском — модель молча теряет середину. Режьте документ на части с перекрытием в пару абзацев.
- Публикация без чтения вслух. Что глаз проскакивает, то ухо часто цепляет — повторы, канцелярит, чужой тон.
Текст с помощью нейросети в учёбе и на работе
Студенты чаще всего берут модель для конспекта и для того, «чтобы было понятнее». Здесь она правда помогает: может объяснить параграф учебника простыми словами или составить план ответа на билет. Проблемы начинаются, когда готовый ответ сдают без правок. Преподаватель видит усреднённый стиль вместо вашей логики, а это уже вопрос академической честности. Рабочий компромисс — план и проверка формулировок, а не готовая работа целиком; подробнее об этом в гайде про нейросеть для учёбы. Детекторы ИИ-текста при этом тоже ошибаются; как они устроены и что на самом деле измеряют, разобрано в статье про детектор текста.
На работе модель заменяет пустой лист, а не профессию. Маркетолог получает пять заголовков для проверки, юрист — черновик письма в нейтральном тоне, менеджер — пересказ длинной переписки перед совещанием. В каждом случае человек, который знает контекст, вписывает имена, суммы и обещания, которых не было во входных данных. Если задача профильная, загляните в отдельные материалы: про ленту и соцсети — нейросеть для SMM, про книги и сценарии — нейросеть для писателя, про ролики и канал — нейросеть для блогера.
Отдельно о бесплатных генераторах текста из поисковой выдачи. У многих из них непонятные правила хранения переписки: ваш текст уходит на чужой сервер, а условия меняются без заметного предупреждения. Для рабочего черновика надёжнее один привычный сервис с понятными правилами, чем десять случайных сайтов. Итоговую версию и список правок храните у себя — чат не архив.
Что делать с громкими обещаниями
Новости о модели, «которая пишет лучше людей», появляются регулярно. Проверяются они проще, чем кажется: откройте чат, дайте модели свою задачу на одну страницу текста и сравните черновик с тем, что написали бы сами за тот же час. Своя задача покажет больше, чем таблица чужих тестов.
Дальше — по жанру. Для шаблонов запросов есть гайд с промптами для текстов, для борьбы с узнаваемым стилем — разбор признаков текста нейросети, для длинных документов — статья про токены и окно контекста. Единороги из 2019 года, кстати, до сих пор полезны как напоминание: связный и уверенный текст ещё ничего не говорит о том, правда ли в нём написана.
Вопросы и ответы
Что такое текстовая нейросеть простыми словами?
Это программа, которую учили продолжать текст. По вашему запросу и уже написанному фрагменту она дописывает следующие куски, пока не решит остановиться. В чате из этого получаются ответы, пересказы, письма и правки.
Как сгенерировать текст нейросетью онлайн?
Откройте чат с языковой моделью и опишите читателя, формат, объём и факты, которыми можно пользоваться. Для длинного текста попросите сначала план, затем пишите по разделам. Шаблоны запросов собраны в гайде с промптами для текстов.
Чем нейросеть для генерации текста отличается от ChatGPT?
ChatGPT — продукт одной компании, OpenAI. «Нейросеть для текста» — общее название для больших языковых моделей разных разработчиков. В одном чате можно переключать семейства — Gemini, Claude, DeepSeek и другие — и не менять саму задачу.
Можно ли распознать текст, написанный искусственным интеллектом?
Иногда по шаблонным зачинам, одинаковым связкам и ровной гладкости. Надёжного способа нет, поэтому лучше править текст под свой голос и сверять факты. Подробный разбор признаков — в статье про похожие тексты.
Какой ИИ для текста онлайн выбрать новичку?
Начните с одной быстрой модели для коротких задач и одной более основательной для длинных правок, например Gemini 3.8 Flash и Claude Sonnet 5.5. Если результат слабый, меняйте сначала запрос и только потом модель.
Можно ли публиковать текст, написанный с помощью нейросети?
За опубликованный текст отвечает тот, кто его публикует. Если модель ошиблась в факте, отвечать за ошибку будет автор. В учёбе действуют правила конкретной школы или вуза, а тексты о медицине, деньгах и договорах должен проверить специалист.
Связанные модели


Связанные гайды
- Промпты для текстов
Шаблоны промптов для деловых писем, ТЗ, рерайта и смены тона в GPThub. Как задать аудиторию, объём и запреты — без канцелярита.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Похожие статьи
- Почему тексты звучат одинаково
Откуда у разных чатов один ровный тон, что в абзаце видно без детектора и почему процент на сайте приговором не стал.
- Нейросеть для постов
Как собирать тексты и картинки для ленты, не терять голос бренда и не путать органику с рекламой. Проверка на 1 ноября 2026 года.
- Нейросеть для писателя
"Нейросеть для писателя ускоряет черновик и часто стирает голос. Где отдать правку, что сверить и почему книгу целиком лучше не отдавать."
- ИИ-чат и поиск
Чем ИИ-чат отличается от поиска: где готовый ответ удобнее списка ссылок, где чат ошибается и когда включать веб-поиск в диалоге.
- Нейросетевой перевод
Модель собирает фразу целиком, а не ищет слово в словаре. Как устроен перевод текста, игр и видео.
- Что такое инференс
Инференс — ответ обученной модели на новых данных, без правки весов. Чем он отличается от обучения и от статистического вывода.
Источники
- Better Language Models and Their Implications (OpenAI, 14 февраля 2019)
- Introducing ChatGPT (OpenAI, 30 ноября 2022)
- Attention Is All You Need (arXiv, 12 июня 2017)
- Gemini 3.8 Flash Model Card (Google DeepMind)
- Claude Sonnet 5.5 (Anthropic)
- Claude Sonnet 5.5 overview (документация Anthropic)
- DeepSeek-V4-Flash (Hugging Face)
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат для текста
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.