
Что такое инференс: ответ нейросети, когда она уже не учится
Обозреватель: как устроен ИИ
Содержание
29 июля 2016 года Кайл Обри выпустил в блоге Nvidia заметку «What’s the Difference Between Deep Learning Training and Inference?». Редакционная помета на той же странице говорит, что текст обновили в октябре 2025 года. В самой заметке инференс описан как применение уже выученного к новым, ещё не виденным данным, с быстрым и точным ответом. Глоссарий Google по машинному обучению держит для того же слова два рабочих определения и отдельно отсылает к статистике. Что такое инференс, из этих страниц собирается без догадок: лекция по теории вероятностей, кредитный скоринг и чат с моделью произносят одно слово про разные действия.
Что такое инференс
Слово пришло из английского inference. В глоссарии Google для обычного машинного обучения инференс — процесс предсказаний: обученную модель применяют к примерам без меток. Для больших языковых моделей определение на той же странице другое. Инференс — использование обученной модели, чтобы породить ответ на входной запрос. Там же оговорка: в статистике у слова смысл другой, и глоссарий отсылает к статье Википедии про статистический вывод.
Глоссарий Nvidia формулирует шире и на той же странице, где разбирает обучение. Инференс — процесс, в котором обученная модель порождает новые результаты на новых данных: классифицирует вход и применяет выученное, в формулировке страницы ещё и в реальном времени. Обучение описано тут же, отдельным блоком, а не на соседней карточке. Модель или сеть учится задаче, подправляя веса по обучающим данным, и делает это многими проходами, особенно на больших наборах и при смене параметров.
Фраза «в реальном времени» из первого определения годится не на все режимы. Та же страница Nvidia ниже описывает пакетный запуск: несколько запросов считают вместе, заранее, чтобы графический процессор был занят. Быстрый ответ в момент запроса — один из способов запуска, не свойство самого слова.
Аналогия со студентом на экзамене врёт в главном. Студент на экзамене всё ещё может запомнить ход, если ему покажут решение. На инференсе записанные веса не двигаются. Сеть прогоняет новый вход через числа, которые уже стоят. Экзамен здесь ближе к калькулятору с зашитой формулой: формулу на листе не правят, подставляют новые величины.
Модель — набор весов и правило, как из входа получить выход. Один прогон этого правила на данных, по которым веса сейчас не подгоняют, и есть тот самый шаг. В глоссарии Google под него попадает и дерево решений, и сеть. Чем машинное обучение шире одной сети, разобрано в материале машинное обучение и нейросеть. У Nvidia к прогону добавлен запуск: скорость, пакеты запросов, несколько проходов у рассуждающих моделей.
Вывод нейросети в бытовом русском часто значит «ответ, который она выдала». В учебнике вывод бывает ещё и статистическим. Путаница живёт в одном английском корне. Её лучше разнять сразу, иначе конспект по скорингу и конспект по чату склеиваются в одну тетрадь.
Чем инференс отличается от обучения
Как учат сеть и почему после заморозки вчерашняя новость в веса не попадает, разобрано в материале как обучают нейросеть. Здесь только развилка. Обучение и инференс начинают с одного и того же прямого счёта. Вход проходит слои, на выходе получается число, класс или кусок текста. Дальше пути расходятся.
При обучении известен желаемый ответ, хотя бы для части примеров. Разницу между тем, что сеть выдала, и этой меткой сворачивают в ошибку. Ошибку разносят назад по слоям и меняют веса. Глоссарий Google называет этот обратный шаг backpropagation: вперёд сеть считает предсказание на пачке примеров и сравнивает его с меткой, назад уменьшает ошибку, двигая веса. Шаг обучения повторяют много раз. Nvidia на странице про инференс пишет то же про обучение: проходов много, особенно на больших наборах и при смене параметров.
При инференсе метки для правки нет, и обратного шага нет. Веса остаются теми, какими их сохранили после обучения. Счёт оптимизируют под скорость. В глоссарии Nvidia среди приёмов названы декодирование с догадкой (speculative decoding), квантование, прореживание и слияние слоёв. Смысл общий: тот же ответ получить дешевле и быстрее, не открывая заново обучение. Страница пишет, что этими приёмами ускоряют ответ и держат точность. Насколько это сходится на конкретном вопросе, из списка приёмов не следует. Список не замер.
Отсюда следствие. Один и тот же вопрос в новом диалоге не доучивает модель на вашей фразе. Если продукт что-то помнит между диалогами, это отдельная запись рядом с моделью, а не градиент по весам. Путать эти две памяти легко, и из путаницы растут почти все бытовые вопросы про «она меня запомнила».
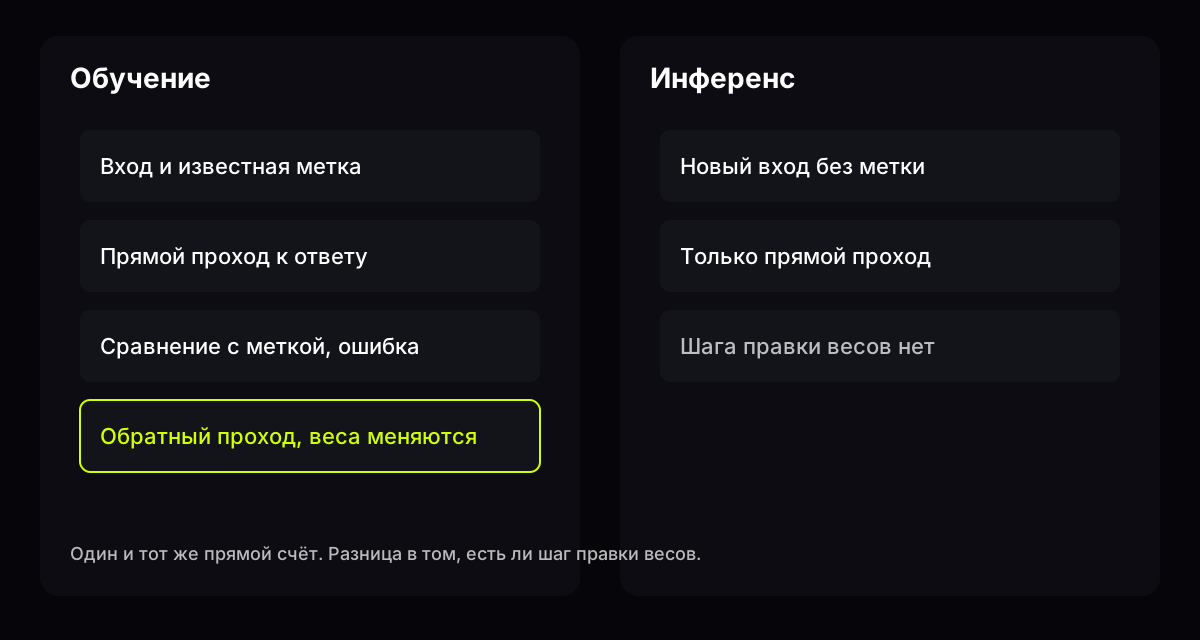
Источник: схема по определениям глоссария Google и глоссария Nvidia, сверка 2 ноября 2026
На схеме лаймом отмечен единственный шаг, которого при ответе нет: правка весов. Всё остальное — чтение уже готовых чисел. Справа этого шага нет, и лайма там нет тоже.
Что делает сеть, когда отвечает
Параметр — одно число внутри модели, его подобрали при обучении. Токен — кусок текста, с которым модель работает за шаг. Окно — сколько таких кусков ещё участвует в расчёте вместе с новым. Токен и окно по отдельности разобраны в материале что такое токен и контекстное окно.
Глоссарий Google называет современные языковые модели на трансформере авторегрессивными. Следующий токен предсказывают по уже предсказанным. Как устроена большая языковая модель, есть отдельный разбор: что такое большая языковая модель. Картиночные модели на генеративно-состязательной сети, по той же странице глоссария, обычно собирают кадр одним прямым проходом, не по шагам. Часть картиночных моделей всё же авторегрессивна: кадр строится по шагам. Для чата важен первый случай. Ошибка в середине фразы меняет то, что модель видит на следующем шаге, и хвост ответа уезжает следом.
Nvidia для языковых моделей рисует путь запроса так. Текст режут на токены. Дальше на графическом процессоре две фазы. Первая обрабатывает токены входа. Вторая порождает токены ответа. Время всего запроса складывается из нарезки, первой фазы, второй и сборки текста обратно. В глоссарии фазы названы по-английски prefill и decode. По-русски это предварительный проход по запросу и пошаговая выдача.
Там же названы три меры, которыми этот путь оценивают.
Время до первого токена — пауза, пока не появится начало ответа. Для человека в чате это и есть ощущение «она думает».
Время на один выходной токен — средний шаг дальше, когда начало уже есть. Страница называет его временем на последующий токен. Длинный ответ копится из этих шагов.
Полезная пропускная способность (goodput) — сколько успевают отдать, пока обе задержки держатся в заранее заданных границах. Nvidia так и пишет: мера держит в балансе задержку, скорость и стоимость, считая пропускную способность только при заданных пределах по двум временам. Голое число запросов в секунду без этих пределов страница отдельно не хвалит. Чат от погони за голым числом становится вязким.
Рассуждающие модели удлиняют тот же инференс, а не возвращаются к обучению. Nvidia пишет про масштабирование на этапе ответа (test-time scaling): модель делает последовательность проходов, порождает больше токенов и более длинный цикл, и за счёт этого ответ на трудной задаче бывает выше качеством. Веса между этими проходами не подгоняют заново. Платят временем и объёмом счёта. В примерах на той странице названы DeepSeek-R1, Gemini 2.0 Flash Thinking и Llama Nemotron. Семейство, к которому относится первая из них, разобрано в материале что такое DeepSeek.
Квантование стоит в том же ряду приёмов ускорения, рядом с прореживанием. Это имя способа ужать счёт на уже обученной модели, не открывая обучение заново. Насколько приём портит конкретный ответ, видно только на проверке, не из самого слова.
Запуск Nvidia делит на четыре способа. Пакетный считает несколько запросов вместе, чтобы процессор был занят. Живой обрабатывает данные в момент прихода, как в задаче, где решение нужно сразу. Распределённый раскладывает счёт по нескольким узлам сразу. Разнесённый делит ход на два этапа, первый разбор и порождение ответа, и ставит этапы на разные машины. Для читателя чата важна первая развилка: ответ посчитали заранее пачкой или считают сейчас, пока открыт диалог.
Пакетный инференс и ответ по запросу
Курс Google по промышленным системам, страница обновлена 3 декабря 2025 года, делит инференс на два режима.
Статический инференс, его же офлайн и пакетный, считает предсказания на пачке обычных примеров без меток и кладёт их в хранилище. Дальше сервис отдаёт уже готовую запись.
Динамический инференс, его же онлайн, считает предсказание в момент запроса клиента.
В курсе есть нарочно крайний пример. Очень сложной модели на одно предсказание нужен час. Для статического режима это как раз удобный случай. Если ту же модель по ошибке звать динамически и запросов много сразу, большинство не получит ответ часами или сутками. Модель, которая отвечает примерно за 2 миллисекунды при относительно малом объёме счёта, уже можно звать по требованию: клиент получает предсказание быстро.
Плюсы статического режима в том же конспекте короткие. О цене счёта можно думать до запуска, а предсказание можно проверить до того, как его отдадут. Минусы тоже короткие. Отдаётся только то, что заранее положили в хранилище, редкий вход может не найтись, обновление тянется часами или днями.
Плюс у динамического режима один, и он важный: оценка на любом новом объекте, в том числе редком. Минусы: счёт тяжёлый, задержка чувствительная, из-за этой пары сложность модели иногда приходится резать. Следить за качеством приходится плотнее. Проверить все ответы до выдачи в общем случае нельзя: их считают в момент запроса. Следить можно за сводным качеством предсказаний, но тревога, по формулировке курса, приходит, когда огонь уже разошёлся.
Чат с языковой моделью живёт во втором режиме. Все фразы заранее не заготовить. Курс сам приводит в пример пространство всех возможных предложений: у свободного входа длинный хвост редких случаев, и заранее запасённая таблица его не покрывает. Балл заявки и рекомендация каталога часто живут в первом режиме: посчитали пачкой, положили в таблицу. Сравнивать паузу чата с уже готовым числом из таблицы значит сравнивать два разных запуска.
Соседняя страница того же курса, про статическое и динамическое обучение, обновлена в тот же день, 3 декабря 2025 года. Там сказано прямо. Если распределение входа меняется, предсказания модели могут стать ненадёжными. Пример на странице бытовой. Модель учили только на летней одежде, а затем спрашивают про зимние покупки. Практический смысл фразы «модель устарела» сидит здесь: числа уже подобраны, а согласие этих чисел с новым входом разъехалось.
Выборка скоринга и выборка инференса
Поисковая фраза склеивает три словаря. Готовой пары «выборка скоринга» и «выборка инференса» в сверенных открытых страницах нет. Есть три соседних смысла, и каждый отвечает на свой вопрос.
Первый смысл — статистика. Статья английской Википедии Statistical inference определяет статистический вывод как анализ данных, чтобы судить о свойствах распределения вероятностей, которое стоит за данными. Предполагается, что наблюдаемый набор взят как выборка из большей совокупности. Описательная статистика смотрит только на уже наблюдаемые числа и на такую совокупность не опирается. Вывод по части судит о целом: проверяет гипотезы, строит оценки. Среди обычных итогов на той же странице — точечная оценка, доверительный интервал, отказ от гипотезы.
Та же статья прямо пишет, что в машинном обучении слово inference иногда значит другое. Предсказание уже обученной моделью называют инференсом. Подгонку свойств модели называют обучением, не инференсом. Кто пришёл из курса матстатистики, чаще всего упирается именно в этот сдвиг имени.
Второй смысл — кредит. Препринт arXiv:2407.13009, «Fighting Sampling Bias: A Framework for Training and Evaluating Credit Scoring Models», отправлен 17 июля 2024 года. Первый автор — Никита Козодой (Nikita Kozodoi), с ним Stefan Lessmann, Morteza Alamgir, Luis Moreira-Matias и Konstantinos Papakonstantinou. Скоринговые модели в финансовых организациях и строят, и оценивают по ранее одобренным заявителям, у которых известен возврат. Это смещение выборки: размеченные данные показывают только часть распределения тех, кого карта должна оценивать.
Авторы предлагают для обучения карты достройку меток у части отклонённых заявок (reject inference): к смещённой обучающей выборке добавляют эти заявки, а метки для них достраивают. Для оценки карты они предлагают байесовскую схему, которая даёт более надёжную оценку будущей работы на смещённых данных.
В аннотации вывод прямой. Достройка меток отклонённым — трудная задача, и выигрыш карты от неё скромный. Полезнее чинить смещение на этапе оценки. В их расчётах выбор порога одобрения по байесовской оценке давал прирост прибыли около восьми процентов. Это цифра одного препринта на данных авторов, не норма для любой организации. Порог одобрения по чужой аннотации не выставляют.
Здесь «инференс» — догадка о скрытой метке отклонённого, а не ответ чата. Выборка, на которой карту строили, состоит из людей с известным исходом. Поток, который карта потом оценивает, включает и тех, кому раньше отказывали, и новых людей без исхода. Второе множество и есть поле инференса в смысле глоссария Google: примеры без метки, модель только считает балл.
Если перевести бытовую пару слов на этот язык, получится так. Выборка скоринга в разговоре — те, кого оценивают баллом, часто уже в бою, без права подкрутить веса на их исходе, потому что исход ещё не наступил. Выборка для статистического вывода — те, по кому хотят судить о совокупности, с известными правилами отбора. Выборка применения модели — новые строки без метки. Называть все три одним именем можно только с уточнением, иначе в зачёте смешаются доверительный интервал и балл заявки.
Третий смысл всплывает в разговорах про чат и звучит похоже на кредит, но устроен иначе. Иногда скорингом называют один проход сети, который расставляет числа по уже заданному списку исходов и не пишет длинный текст. Это всё ещё инференс языковой модели, только без пошаговой выдачи длинного ответа. Открытого учебника, где эта инженерия названа «выборкой инференса», при сверке не нашлось, поэтому в факты статьи она не попала. Для запроса из поиска достаточно не спутать её со скоринговой картой.
Один запрос по шагам
Путь, который Nvidia рисует для языковой модели, можно разложить на короткой фразе, не замеряя секунды и не принимая гладкий тон за сверку.
Запрос, помеченный как образец, не как отчёт о прогоне. «Назови год публикации заметки Nvidia о разнице обучения и инференса. Ответь одним числом из списка: 2014, 2016, 2018, 2025.»
Смотреть три вещи. Вышла ли модель из списка. Совпало ли число с датой на странице блога, 29 июля 2016 года, а не с годом редакторской пометы об обновлении. Не звучит ли второе, более уверенное повторение в новом диалоге как доказательство. Веса между диалогами не подгоняют. Каждый раз заново выбирают продолжение. Сверять год надо по странице, которую вы сами открыли, а не по тому, что второй ответ прозвучал ровнее.
Второй запрос уже про режим, а не про дату. «Пока ты пишешь этот ответ, веса модели меняются или остаются теми, какими их сохранили после обучения? Ответь в двух предложениях и не описывай, как модель учили.»
Смотреть, не подменила ли модель инференс обучением. Обратный проход и правка весов в этом ответе лишние. Если текст говорит, что модель учится на вопросе, это путаница двух режимов. Её видно без отдельного замера: определение на странице Google обратного шага в ответ не включает.
Третий запрос проверяет окно, не память обучения. В начало диалога кладут короткий документ, в конце спрашивают про его первые строки. Если ответ пересказывает только хвост, дело в длине входа и в том, как модель тратит внимание. Окно и внимание — свойства уже обученной модели на инференсе. «Забыла обучение» — неверное имя для этой ошибки. Обучение к этому часу уже закончилось.
Просьба «запомни это навсегда и поправь себя» проверяет ожидание, а не память. Новый диалог без этой фразы начинается с тех же весов. Если продукт подмешивает прошлые реплики, это снова запись рядом с моделью. Её можно стереть, не переучивая сеть.
Как проверить ответ, не путая его с обучением
Практическая часть короткая. Речь про то, что смотреть в ответе, а не про курс запросов. Как выбирать модель под задачу, разобрано в гайде как выбрать модель. Как гонять один и тот же кусок работы на нескольких моделях, есть в гайде сравнение моделей на практике. DeepSeek V4 Flash уже доступна в чате GPThub. Gemini 3.8 Flash уже доступна в чате GPThub. Что умеет вторая из них, разобрано в статье Gemini 3.8 Flash.
Один и тот же фактический вопрос имеет смысл задать дважды, в двух новых диалогах, с одной и той же формулировкой. Если даты, имена и числа разъехались, это ожидаемое следствие авторегрессивного шага. Сеть каждый раз заново выбирает продолжение. Сверять такие места надо по учебнику или по документу, который вы сами приложили.
Запрос с закрытым списком проверяет дисциплину хода, а не знания. Формулировка вроде «ответь одним словом из списка: да, нет, неясно» на факте, который легко открыть в учебнике, показывает, вышла ли модель из списка. Выход из списка — сбой инструкции на инференсе. Верное слово из списка ещё не значит, что факт верен: слово могли выбрать мимо источника.
Ошибки на этом месте повторяются, и у каждой своё имя.
Кто называет инференсом построение доверительного интервала, ждёт, что чат посчитает его как статистический пакет, с выбранным критерием и оговорками. Чат может написать формулу. Проверка условий применимости остаётся на человеке, потому что ответ языковой модели и вывод о совокупности — разные действия.
Удачный ответ не дописывается в веса выпуска. Через сто диалогов модель не становится личной копией. Личное копится только там, где продукт отдельно хранит текст.
Ровный тон не признак сверки с источником. Тон получается из продолжения текста. Сверка с внешним источником включается, только если её устроили: приложили документ, открыли поиск, сверили цитату руками.
Пакетный балл и живой чат путают, а потом удивляются паузе до первого токена. Пауза — цена динамического режима на большой сети. У пакетного режима пауза для человека другая: её уже пережили заранее, в таблицу легло готовое число.
Ещё одна проверка полезна на спорных формулировках. Попросите перечислить, какие куски ответа следуют из приложенного текста, а какие додуманы. Модель может ошибиться и в этой разметке. Но разметка хотя бы отделяет пересказ от достройки, а достройка на инференсе как раз и есть место, где веса считают ответ без метки.
Что из этого следует на практике
Если новость говорит, что модель «научилась» на вашем вопросе, сначала стоит открыть, менялись ли веса или вырос только ответ. Короткий ответ, длинная цепочка рассуждения и балл по закрытому списку — три разных расхода одного и того же инференса. Обучение в этот вечер уже закончилось, иногда за месяцы до вопроса.
Если задача похожа на кредитный скоринг, а не на чат, сначала стоит нарисовать две таблицы. В одной строки с известным исходом, по ним когда-то подбирали веса. В другой строки без исхода, по ним сейчас считают балл. Вторая таблица — инференс. Смешение этих таблиц как раз и даёт смещение, о котором пишут Козодой и соавторы: карта видела только одобренных, а в бою перед ней все.
Если задача похожа на статистический вывод, ответ модели её не заменяет. Доверительный интервал живёт на предположениях об отборе и о модели шума. Предсказание сети живёт на весах и на сегодняшнем входе. Оба действия по-английски иногда называют inference. По-русски их лучше разводить: вывод о совокупности и ответ модели.
Для выбора, какую сеть звать на живой инференс, смотрят не на слово «умная», а на режим. Нужен короткий ответ на типовой вопрос или длинный ход на трудной задаче. Нужна пачка на ночь или ответ, пока открыт диалог. Эти развилки раньше любых сравнений «кто новее». Сравнение само полезно потом, на одном и том же абзаце, с одной и той же проверкой фактов.
Вопросы и ответы
Что такое инференс?
Применение уже обученной модели к новым данным. В глоссарии Google для обычного машинного обучения это предсказание на примерах без меток, для большой языковой модели — порождение ответа на запрос. Веса на этом шаге не подгоняют. В статистике то же английское слово значит другое: суждение о совокупности по выборке.
Что такое инференс модели?
Это один прогон уже обученной модели на данных, по которым веса сейчас не подгоняют. На выходе предсказание, класс, балл или текст. Метку для обратного прохода на этом шаге не используют.
Что такое инференс в машинном обучении?
В глоссарии Google это предсказание обученной модели на примерах без меток. Туда попадает и дерево, и сеть, и скоринговая карта в момент, когда она ставит балл новой заявке. Обучение, где веса ещё меняются, в это определение не входит.
Что такое инференс в ИИ?
Тот же прогон, плюс запуск вокруг языковых моделей: нарезка на токены, предварительный проход по запросу, пошаговая выдача, пакеты, задержка до первого токена. Nvidia отдельно относит сюда несколько проходов рассуждающей модели на время одного ответа.
Что такое вывод нейросети?
В бытовом смысле это текст или класс, который сеть выдала на инференсе. В курсе статистики «вывод» значит другое: суждение о совокупности по выборке. Английский корень один, действия разные, и в зачёте их лучше называть полностью.
Чем выборка скоринга отличается от выборки инференса?
Устойчивой пары с такими именами в сверенных источниках нет. На практике различают выборку с известным исходом, по которой карту учили, и новые строки без исхода, по которым считают балл. Второе — инференс в смысле машинного обучения. Статистическая выборка для вывода о совокупности — третья сущность, про доверительные интервалы, а не про ответ чата.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Сравнение моделей
Как честно сравнить две модели в GPThub: один промпт, критерии, новый чат vs смена модели. Без фейковых «мы лучше всех» и API-рейтингов.
Ещё по теме
Источники
- Глоссарий машинного обучения Google, статья inference
- Статический и динамический инференс, курс Google, обновление 3 декабря 2025
- Статическое и динамическое обучение, курс Google, обновление 3 декабря 2025
- Что такое инференс ИИ, глоссарий Nvidia
- Заметка Nvidia об обучении и инференсе, Кайл Обри, 29 июля 2016, обновление в октябре 2025
- Statistical inference, английская Википедия
- Kozodoi et al., Fighting Sampling Bias, arXiv:2407.13009, 17 июля 2024
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.