
Как устроен детектор текста ИИ и что он измеряет
Обозреватель: как устроен ИИ
Содержание
20 июля 2023 года, как написано на странице классификатора OpenAI, инструмент закрыли: точность слишком низкая. Выложили его 31 января того же года. На английском проверочном наборе он верно помечал как «скорее написано ИИ» лишь 26% машинных текстов и в 9% случаев ставил ту же метку человеческому тексту. Детектор текста ИИ с тех пор никуда не делся. В поиске по-прежнему просят отличить машинный абзац, и экран по-прежнему отвечает процентом. Процент измеряет не автора. Он измеряет, насколько отрывок похож на то, что выбранная программа считает типичным для машины, и проходит ли эта похожесть заранее поставленный порог.
Откуда взялась привычка ловить машинный абзац
Для понимания нынешнего процента на экране нужно отступить на несколько лет, к моделям, которые ещё не умели держать длинный разговор.
10 июня 2019 года Себастьян Герман, Хендрик Штробельт и Александр Раш описали GLTR. Это была не тайная экспертиза, а подсветка для глаз. Программа смотрела, какие слова в тексте оказались для языковой модели слишком удобными, и красила их так, чтобы человек видел рисунок. В опыте с людьми доля обнаружения поддельного текста выросла с 54% до 72%. Никакого курса перед этим не было. Уже тогда измерили не «душу автора», а статистический след выбора слов.
Дальше модели стали беглее, и след сделался тоньше. 31 января 2023 года на странице OpenAI появился отдельный классификатор. Подпись: Ян Хендрик Кирхнер, Лама Ахмад, Скотт Ааронсон и Ян Лейке. Его учили отличать человеческие тексты от текстов разных систем. В сопроводительном тексте компания сразу написала неудобную фразу: надёжно обнаружить весь машинный текст невозможно. Цифры проверки это подтвердили. На английском проверочном наборе метку «скорее написано ИИ» получали 26% машинных отрывков. Человеческий текст получал её в 9% случаев. С длиной надёжность обычно росла. Ниже 1000 знаков прибор, по словам компании, был очень ненадёжен, и даже длинный текст иногда помечался неверно. Иногда живой абзац получал метку уверенно и зря. Сами авторы просили не делать классификатор главным основанием решения, только дополнением к другим способам. До него у компании уже был более ранний классификатор, и новый на текстах более свежих систем работал заметно надёжнее. 20 июля того же года инструмент выключили.
Привычная картинка, будто программа читает стиль так же, как преподаватель, врёт уже в устройстве прибора. Преподаватель держит в голове задание, прошлые тетради и то, как именно этот человек обычно спорит с источником. Детектор держит шкалу и ничего больше. На одном конце тексты, которые модель или обучающая выборка считает машинными. На другом — те, что считает человеческими. Новый абзац падает куда-то между, и кто-то заранее решает, с какой отметки писать «подозрительно».
Токен — кусок текста, которым модель реально оперирует, и это часто не целое слово, а корень, окончание или отдельный знак препинания. Как текст режется и почему длинный разговор начинает «забывать» начало, разобрано в статье про токен. Удивление токена — насколько мала была его вероятность после уже написанного куска. Перплексия всего абзаца — среднее такое удивление, свёрнутое в одно число, чтобы два текста можно было положить на одну ось. Порог — число, выше или ниже которого экран меняет подпись с «похоже на человека» на «похоже на машину». Эти три величины описывают почти любой статистический детектор, даже если сайт прячет их за одним процентом. Классификатор, обученный на примерах, прячет ту же идею внутрь весов, но на выходе всё равно остаётся сравнение с порогом.
Технический отчёт GPT-4 говорит о генераторе прямо. Модель архитектуры Transformer предобучена угадывать следующий токен документа. Так устроена большая языковая модель: когда она пишет, она снова и снова выбирает продолжение из распределения вероятностей. Гладкость, которую ловят детекторы, рождается здесь. При обычном выборе машина реже ставит слово, которое для неё самой было бы диким. Почему такие абзацы ещё и звучат похоже друг на друга, разобрано отдельно, в статье про признаки текста нейросети.
Что измеряет детектор текста ИИ
Снаружи запрос звучит так, будто прибор видит автора. На деле у него три разных вопроса, и путать их нельзя.
Первый вопрос: насколько продолжения в тексте были ожидаемы для конкретной языковой модели. Если почти каждое слово сидело в верхней части её списка, отрывок «слишком удобный». GLTR показывал это человеку цветом. Методы без отдельного обучения, вроде оценки по вероятностям, делают из того же материала одно число.
Второй вопрос: на какую сторону обученного классификатора падает отрывок. Здесь уже не обязательно спрашивать ту модель, которая текст написала. Сеть видела тысячи чужих примеров и выучила свои приметы. Приметы устаревают. Классификатор OpenAI как раз из этого семейства, и его собственные 26% и 9% показывают цену ошибки, когда приметы слабые. Для веб-формы порог уверенности компания держала так, чтобы ложных меток было мало, и ставила пометку только при большой уверенности. Это отдельная настройка экрана, не второе имя тех же 26%.
Третий вопрос задают только если текст пометили при рождении. Водяной знак Кирхенбауэра и соавторов (работа января 2023 года, конференция ICML 2023) не ищет «роботный стиль». Перед каждым словом генератор случайно делит словарь на предпочтительные и обычные токены и чуть чаще берёт первые. Читатель сдвига не замечает, так пишут авторы. Проверяющий считает, не слишком ли много «зелёных» токенов выпало для честной случайности, и получает оценку значимости: насколько такая удача была бы редкой без закладки. Параметры исходной модели и вызов её интерфейса для проверки не нужны.
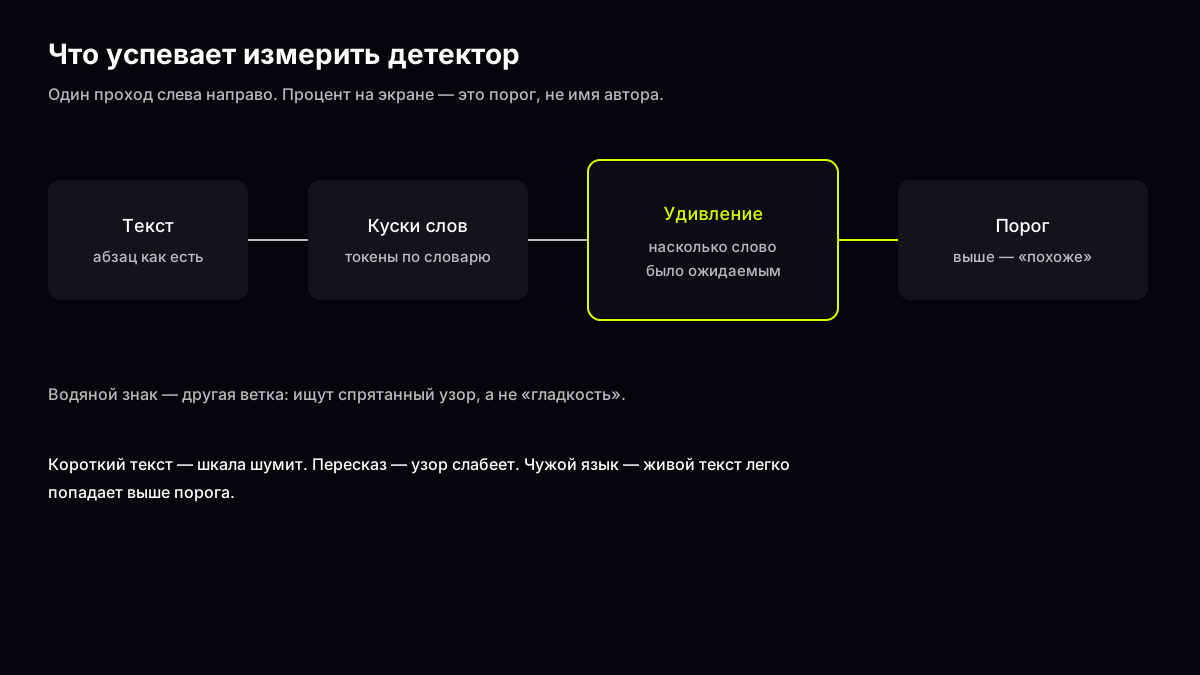
Источник: схема по устройству статистического детектора, GLTR (2019) и страница OpenAI от 31 января 2023. В рисунке нет нового замера.
Кривизна, о которой написали Митчелл и коллеги в DetectGPT (январь 2023, ICML 2023), уточняет первый вопрос. Мало знать, что текст вероятный. Авторы смотрят, что будет, если слегка переписать отрывок другой моделью, в их опыте это T5, и заново спросить логарифм вероятности у подозреваемой модели. Машинный текст, по их наблюдению, сидит в ямке: соседние пересказы для той же модели менее вероятны. Человеческий текст такой ямки не образует. Отдельный классификатор для этого не тренируют. На фальшивых новостях, которые написала GPT-NeoX с 20 миллиардами параметров, площадь под кривой ошибок выросла с 0,81 у сильнейшего прежнего метода без дообучения до 0,95.
Binoculars (Ханс и соавторы, январь 2024, ICML 2024) сравнивает уже две близкие модели между собой. Одна оценивает, насколько текст для неё обычен. Вторая смотрит на те же токены чуть иначе. Расхождение даёт оценку без учебной выборки машинных текстов и без подстройки под конкретный генератор. В их сводке, на разных типах документов, метод находил более 90% образцов ChatGPT и других больших моделей при доле ложных срабатываний 0,01%. На данных ChatGPT его не обучали. Это сильная лабораторная точка. Она не равна обещанию любого сайта с полем «вставьте текст».
Смысл измерения в итоге один. Детектор почти никогда не возвращает имя программы, которая писала абзац, если только в текст не вложили водяной знак именно этой программы. Он возвращает положение на шкале и решение порога. Порог можно сдвинуть. Сдвинете в сторону осторожности — пропустите больше машинных работ. Сдвинете в сторону строгости — начнёте метить живые.
Как работает детектор ИИ текста на практике
Фраза из поиска, «как работает детектор ии текста», обычно хочет кнопку. Кнопки устроены похоже, даже когда лаборатории спорят о математике.
Текст режут на токены тем словарём, под который считали шкалу. Чужой словарь уже меняет число. Дальше либо считают удивление и кривизну, либо прогоняют вектор через обученную сеть, либо ищут водяной знак. На выходе получается сырая оценка. Её сравнивают с порогом и иногда растягивают на «проценты», чтобы экран выглядел понятным. Процент здесь не доля абзаца, написанная машиной. Это перерисованная оценка. Два сайта с разными порогами покажут разные проценты на одном и том же файле, и оба будут верны своим правилам.
Длина входит в измерение напрямую. OpenAI писала, что надёжность их классификатора обычно росла вместе с длиной, а ниже 1000 знаков он очень ненадёжен. Короткий ответ даёт мало токенов, и случайный всплеск обычных слов уже толкает оценку через порог, хотя автор никуда не делся. Отрывки около 300 токенов фигурируют в работе Садасивана и коллег не случайно. На такой длине ещё есть что считать, и уже можно устроить пересказ.
Смешанный текст — отдельный капкан. Человек вставил машинный кусок в свою главу или поправил машинный черновик своими фразами. Шкала видит среднее. Среднее умеет оказаться посредине, где подпись звучит уверенно, а состав абзаца двойной. Подсветка подозрительных предложений, если она есть, честнее одного числа на весь файл. Но подсветка тоже порог, только покороче, и на коротком она шумит сильнее.
Водяной знак ломается иначе, чем классификатор. Ему нужен генератор, который согласился метить текст. Обычный чат без этой закладки водяной знак не несёт, и искать его бессмысленно. Если закладка была, пересказ и замена слов размывают «зелёную» статистику. На странице от 31 января OpenAI прямо пишет, что машинный текст можно отредактировать так, чтобы классификатор его пропустил. Работа о надёжности детекции показывает то же направление на опытах: рекурсивный пересказ снижает срабатывание разных семейств, включая водяные знаки, и при этом качество текста во многих случаях падает лишь немного.
Есть и обратная порча. Та же работа показывает, что спрятанную подпись можно пытаться восстановить без внутреннего доступа к детектору и затем подсунуть человеческому тексту. Репутационный риск ложится на разработчика модели. Человека можно оговорить машинным узором, которого он не ставил.
Модели, которые предсказывают следующий токен, в бытовом чате уже обычны. Модель Grok уже доступна в чате GPThub, как и DeepSeek. Детектор не сидит внутри их ответа. Он смотрит на готовые буквы снаружи, если вообще умеет смотреть на этот тип генерации. Карточки Grok и DeepSeek описывают сами модели, не прибор для проверки авторства.
Почему английский лабораторный порог не переносится в русскую работу
Лабораторные цифры из раздела выше легко принять за инструкцию к любой форме в браузере, и именно здесь измерение чаще всего подменяют обещанием. Binoculars считает расхождение двух близких моделей на документах, которые авторы сами разложили по типам, и публикует долю ложных тревог для этого протокола. DetectGPT смотрит кривизну логарифма вероятности у конкретной модели, в знаменитом примере у GPT-NeoX, после возмущений другой моделью. Классификатор OpenAI был отдельной обученной сетью на английском проверочном наборе и закрыт 20 июля 2023 года вместе со своими 26% и 9%. Перенести порог с одной из этих шкал на русскую курсовую нельзя даже арифметически: другой словарь токенов, другая длина, другая доля шаблонных оборотов из методички. Сама компания советовала гонять тот классификатор только по-английски. На других языках он работал заметно хуже, на коде был ненадёжен.
Русский академический абзац часто состоит из определений, которые студент обязан повторить близко к учебнику. Для модели, которая угадывает следующий токен, такой абзац выглядит ожидаемым, потому что определения и правда ожидаемые. Очень предсказуемый текст компания приводила как предел: список первой тысячи простых чисел одинаков, кто бы его ни выписал, и сказать, человек это или машина, нельзя. Методичка слабее этого предела, но из того же ряда. Детектор, если его вообще гоняли на русских методичках, должен был видеть эту ожидаемость и у людей. Если его гоняли на английских эссе и новостях, он увидит ровность и поднимет оценку машинности там, где человек просто следовал плану кафедры. Это не дефект студента. Это перенос порога в задачу, для которой порог не считали.
Смешение с проверкой заимствований добавляет вторую путаницу. Поиск совпадений с уже опубликованными страницами отвечает на вопрос «этот кусок уже где-то лежал». Детектор отвечает на вопрос «этот кусок похож на выборку машины». Совпадение с учебником может быть честной цитатой. Гладкий пересказ учебника своими словами может не совпасть ни с одной страницей и всё равно получить высокий машинный балл. Обратный случай тоже обычен: машина собрала редкие формулировки из нескольких источников, поиск заимствований молчит, а статистика удивления уже не молчит. Два прибора нельзя складывать в одну подпись «работа написана не студентом».
Дата проверки имеет тот же вес, что и дата статьи в лаборатории. На 2 ноября 2026 страница классификатора OpenAI по-прежнему содержит приписку от 20 июля 2023 и те же 26% с 9%. Нового отчёта с другими процентами на ней нет. Первичной таблицы Яндекса с методом и долями при той же проверке не нашлось. Любая форма, которая обещает свежесть «на этот месяц» без протокола, измеряет готовность витрины, а не расстояние между человеческим и машинным текстом. Если выйдет новый отчёт с длиной, языком и долей ложных тревог, сравнивать его придётся с Binoculars и с закрытым классификатором по этим трём графам, а не по одному числу на кнопке.
Где шкала врёт даже при честном пороге
6 апреля 2023 года группа Ляна, Юксекгонула, Мао, Ву и Цзоу выложила работу, которую потом напечатал журнал Patterns. Детекторы, которые они проверяли, устойчиво принимали английские тексты неносителей за машинные. Тексты носителей опознавали как человеческие. Простой переспрос модели умел и уменьшить этот перекос, и провести машинный текст мимо тех же детекторов. Авторы прямо не советуют ставить такие приборы в оценку и в учёбу, если цена ошибки — человек со стеснённым языком.
Для русского читателя вывод практический, хотя статья написана про английский. Детектор, который учили на беглых текстах одного языка, видит осторожный синтаксис, повтор частых слов и ровную грамматику как «машинность». Так пишет и человек, который думает на другом языке, и сильный генератор. Прибор не спрашивает, откуда ровность.
Вторая дыра — теоретическая, и она неприятнее любых процентов на лендинге. Садасиван и коллеги связывают площадь под кривой лучшего мыслимого детектора с тем, насколько вообще различаются распределения человеческого и машинного текста. Если распределения сближаются, даже идеальный порог начинает путать классы. Полная вариация — имя этого расстояния. Когда генератор научился звучать как люди на данной задаче, измерять остаётся всё меньше. Закрытие классификатора на этом фоне читается спокойнее, но в приписке названа другая причина: низкая точность. Работа Садасивана объясняет, почему точность упирается в потолок, когда классы перекрываются. Это соседний аргумент, не цитата компании.
Третья дыра бытовая. Детектор не знает задания. Реферат по методичке, где у всех одни и те же определения, будет гладким у честного студента. Гладкость здесь из учебника, не из нейросети. И наоборот, машина, которую попросили писать короткими рваными фразами и с бытовыми оговорками, уводит статистику удивления. Обход, описанный у Ляна и у Садасивана (у второго работа выходила с правками до января 2025 года), как раз игра с формулировкой, а не с «секретом стиля».
Гайд о нейросети для учёбы стоит на другой стороне той же истории. Он говорит не сдавать чужой текст как свой. Устройство детектора этого совета не отменяет. Прибор слишком часто ошибается, чтобы служить оправданием, и слишком часто ловит гладкость, чтобы служить индульгенцией.
Детектор ИИ текста Яндекса и проверка из поиска
Запросы «детектор ии текста яндекс» и «проверить текст детектор ии» на 2 ноября 2026 года ведут в основном на коммерческие формы. Открытого документа Яндекса, где были бы названы метод, длина проверочного набора, доля верных поимок и доля ложных меток, при проверке в этот день не нашлось. Выдача вела на обзоры сервисов, не на страницу разработчика. Поэтому здесь не будет процента «яндекс-детектора» и не будет утверждения, что поиск штрафует страницу за сам факт нейросети.
Путать две разные службы легко. Поисковая выдача решает, полезен ли документ читателю. Детектор решает, похож ли абзац на машинную выборку. Это разные пороги и разные ошибки. Сайт может быть машинным и полезным. Сайт может быть человеческим и пустым. Оценка поиска, даже если бы она была полностью расписана, не стала бы заменой подписи «этот абзац написал человек».
Коммерческая форма из выдачи обязана показывать хотя бы четыре вещи, иначе процент декоративный. Какая длина текста для неё минимальна. На каких языках её проверяли. Какая доля ложных срабатываний на человеческих текстах этого языка. Умеет ли она только одну оценку на весь файл или ещё подсветку кусков. Если форма молчит, она измеряет неизвестно что. Лабораторные 0,01% ложных срабатываний у Binoculars относятся к их протоколу и их документам, не к соседней вкладке браузера.
Отдельная осторожность — имена моделей на таких формах. Список «мы узнаём все свежие версии» без отчёта, на каких версиях считали и когда, не является измерением. Пока отчёта нет, в текст нечего переносить.
Что проверять, когда процент уже на экране
Практическая часть короткая, потому что пошаговый рецепт «обойди детектор» был бы вреден и всё равно устарел бы быстрее статьи. Смотреть стоит на условия числа.
Сначала длина. Пара предложений для шкалы, которая у OpenAI хорошеет с длиной и сама компания назвала ненадёжной ниже 1000 знаков, почти лотерея. Если форма приняла заголовок и три строки, низкий или высокий процент одинаково мало значит.
Потом язык и регистр. Работа Ляна предупреждает, что неродной английский детекторы путают с машиной. Русский академический шаблон, перевод, речь человека, который пишет редко, дают ту же ровность. Имеет смысл прочитать абзац вслух. Живая речь спотыкается не там, где «нейросеть всегда спотыкается». У машины спотыкание тоже заказывают запросом. Что такое запрос само по себе, разобрано в статье что такое промпт.
Затем состав. Один процент на десять страниц скрывает границу между своим и вставленным. Ищите стык: внезапная гладкость определений после черновых заметок, или наоборот. Стык не доказательство. Это место, где стоит перечитать источник и спросить автора, как он получил формулировку.
Дальше — что число вообще обещает. «92% ИИ» без ложных срабатываний и без имени метода сравнивать не с чем. У DetectGPT на одной задаче площадь под кривой 0,95 против 0,81 у прошлого метода. У классификатора OpenAI на другой задаче 26% поимки. Оба числа настоящие. Они про разные вопросы. Сайт, который печатает только «92», выбирает самое удобное для витрины.
И наконец цель проверки. Если нужно понять, можно ли опереться на текст как на источник, детектор не помогает. Машинный абзац бывает аккуратно сверен с документом, человеческий — выдуман. Почему модель выдумывает и как ловить это по источникам, а не процентом, разобрано в статье почему нейросеть выдумывает. Для сверки фактов нужен первоисточник, как в разборе что такое DeepSeek или в обзоре Grok 4.7: дата, документ, что именно изменилось. Для учёбы нужен свой ход мысли. Как ставить запрос, чтобы модель помогала думать, а не подменяла работу, разобрано в гайде как писать запросы. Детектор в этой паре лишний свидетель.
Если вы видите новость, что «новый детектор узнаёт 99% текстов», откройте, на какой длине, на каком языке, при какой доле ложных тревог и переживает ли оценка пересказ. Четыре числа из работ, которые уже лежат на столе, полезнее одного рекламного. 54 и 72 у GLTR — это люди с подсветкой, 2019 год. 26 и 9 — закрытый классификатор, английский набор, 2023 год. 0,81 и 0,95 — одна лабораторная задача DetectGPT. Более 90% при 0,01% ложных тревог — сводка Binoculars, не универсальный закон.
Вопросы и ответы
Как определить текст нейросети без специальных программ?
По одному абзацу надёжно никак. Гладкость, ровные абзацы и частые слова бывают и у человека, и у модели, которая угадывает следующий токен. Имеет смысл смотреть длину, стыки стиля и то, есть ли у утверждений источник. Программа с процентом делает более узкую работу: сравнивает текст со своей шкалой.
Как работает детектор текста ИИ, если он показывает проценты?
Он получает сырую оценку удивления, классификатора или водяного знака и растягивает её на шкалу, которую удобно показать. Процент не равен доле машинных предложений. Два разных порога дадут два разных процента. У классификатора OpenAI длина это заметно меняла, а ниже 1000 знаков компания сама называла прибор очень ненадёжным.
Детектор ИИ текста Яндекса — где его метрики?
На 2 ноября 2026 открытого отчёта Яндекса с долей поимки и долей ложных меток при подготовке статьи не нашлось. Формы из поиска, которые ставят на витрину слово «Яндекс», без такого отчёта нечем отличить от любого другого порога. Путать их с правилами поисковой выдачи тоже не стоит: это разные задачи.
Что даёт проверить текст детектором ИИ перед сдачей работы?
В лучшем случае — повод перечитать места, которые шкала считает слишком ожидаемыми. Это не справка об авторстве и не защита, если в файл вставлен чужой готовый текст. Пересказ, который сбивает детектор в лабораторных опытах, качество мысли не создаёт. Для учебной работы ориентир другой: свой текст, свои источники.
Какая проверка текста детектором ИИ вообще сравнивает методы честно?
Та, где названы длина отрывков, язык, доля ложных срабатываний и что сделали с текстом потом: оставили как есть или пересказали. Binoculars публикует очень низкую долю ложных тревог на своём наборе. Классификатор OpenAI публиковал гораздо более скромную поимку. Прятать одно число и молчать про второе — уже не сравнение.
Есть ли один прибор на все языки и длины?
Одного прибора на все языки и длины не собрано. Водяной знак силён только там, где генератор сам метил текст. Статистика сильна, пока машинное и человеческое распределения различимы, и слабеет, когда их сближают или когда язык автора для детектора непривычен. Выбор «лучшего» без протокола проверки — реклама.
Связанные модели


Связанные гайды
- Нейросеть для учёбы
Как готовиться с GPThub: конспект, объяснение темы, проверка себя. Честные правила — не сдавать чужой текст за свой. Модели для старта и скринов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Ещё по теме
Источники
- GLTR, статистическая подсветка генерации, июнь 2019
- Водяной знак для языковых моделей, Кирхенбауэр и соавторы
- DetectGPT, кривизна вероятности
- Классификатор OpenAI, 31 января 2023, приписка о закрытии с 20 июля 2023
- Технический отчёт GPT-4: предсказание следующего токена
- Можно ли надёжно детектировать машинный текст, TMLR
- Перекос детекторов против неносителей английского
- Binoculars, ICML 2024
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Как пользоваться нейросетью в учёбе
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.