"Генерация изображений по описанию: как писать запрос к картинке"
Обозреватель: как устроен ИИ
Содержание
22 августа 2022 года Stability AI выложила в открытый доступ веса Stable Diffusion v1.4, и для запуска хватало видеокарты примерно с 6,9 ГБ памяти. С того дня генерация изображений по тексту перестала быть демонстрацией из лаборатории и стала обычным инструментом. За четыре года генераторы научились держать надписи, правку и несколько опорных снимков, но одно правило не изменилось — качество кадра упирается в ясность описания, а не в «волшебное слово». Ниже разобран язык описания: что назвать, в каком порядке и что проверить на выходе.
Чем генерация отличается от поиска картинки
На вход генератору подают строку текста, иногда ещё и опорное изображение. На выходе получается файл, которого до запроса не существовало. У многих генераторов, начиная со Stable Diffusion, внутри работает диффузия — кадр «проявляют» из шума за десятки шагов, а текст на каждом шаге подсказывает, в какую сторону двигаться. Эту механику без формул разбирает статья о том, как нейросеть рисует; здесь важнее другое — что именно вы пишете в строке запроса.
Привычная аналогия звучит так: генератор — это поисковик по картинкам, который находит похожее и отдаёт вам. Аналогия ломается сразу. В готовой модели нет каталога файлов, из которого что-то копируют. Есть огромный набор числовых параметров, в которых при обучении закрепились закономерности: как лежит тень у округлого предмета, как выглядит морская пена, где обычно стоит горизонт. Из этих закономерностей модель каждый раз собирает новый кадр. Ближе художник, который рисует по памяти, — только память у него статистическая, и детали он путает.
Отсюда следствие для автора запроса. Запрос работает как инструкция художнику, который не видел вашего эскиза. Список разрозненных тегов работает плохо: модель не понимает, какой элемент главный и как связаны остальные. Если в тексте не сказано, откуда падает свет, модель выберет самый частый вариант из обучения — обычно ровное дневное освещение без характера. Если не сказано, на каком расстоянии камера, получится средний план «ни о чём». Хороший запрос снимает эти умолчания и задаёт сцену явно. Две короткие фразы про свет и расстояние часто весят больше, чем абзац о «красоте» кадра.
Пять слоёв описания
Удобно думать о запросе как о стопке прозрачных листов. Снизу предмет и действие. Выше свет и время суток. Затем ракурс. Ещё выше стиль и материалы. Сверху перечень запретов — что модель не должна добавлять от себя.
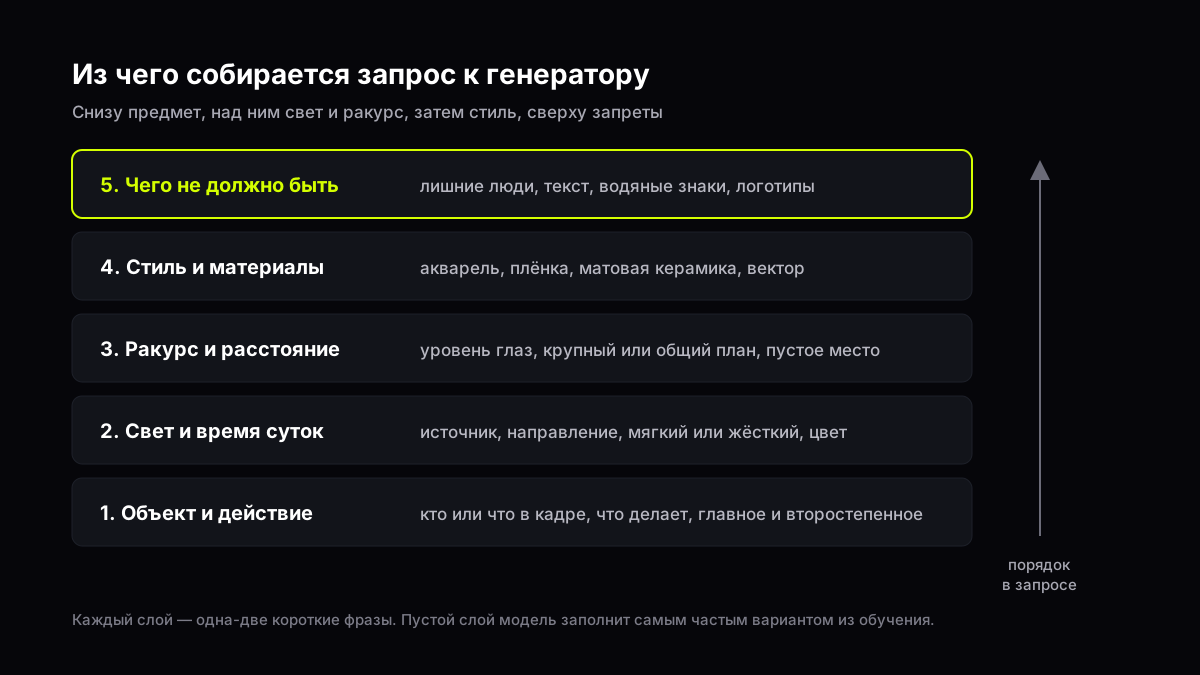
Схема слоёв запроса, иллюстрация GPThub
Объект и действие
Начинайте с одного главного предмета или героя. «Чашка кофе на столе» уже лучше, чем «утро и уют». Ещё лучше — глагол или состояние: «чашка кофе, от которой идёт пар», «кот спит на подоконнике, хвост свисает». Если в кадре несколько предметов, назовите их роли: «в центре — груша, слева от неё — нож, лезвие к зрителю».
Имена собственные и редкие вещи модель понимает через знания о мире, но проверять их всё равно нужно. В документации OpenAI для GPT Image приведён пример: запрос про шкаф с полудрагоценными камнями даёт узнаваемые аметист, розовый кварц и нефрит без опорного фото. Это не гарантия для любой детали — в карточке Nano Banana 2.1 Google прямо пишет, что знания о мире и трёхмерное мышление у модели всё ещё ограничены. Если нужен конкретный сорт яблока или точная модель автомобиля, опишите форму и цвет, а не только название.
Свет и атмосфера
Свет задаёт настроение сильнее, чем прилагательное «красивый». Назовите источник: «мягкий свет из окна слева», «одна настольная лампа с тёплым светом», «жёсткая вспышка в лоб, как на фото для документов». Добавьте время суток: «сумерки, небо ещё синее», «полдень, короткие тени». Если нужен туман, дождь или пыль в луче, скажите прямо, одной фразой, без поэзии на полстраницы.
Ракурс и композиция
Ракурс — положение воображаемой камеры. «Вид сверху на стол», «уровень глаз кота», «крупный план рук, фон размыт» — три разных кадра из одного предмета. Укажите, сколько пустого места оставить: «много неба над горизонтом» для обложки, «плотный кадр, края обрезаны» для значка.
В карточке Nano Banana 2.1 среди ограничений Google называет путаницу с пространственными указаниями вроде «слева» и «справа». Если расположение критично, продублируйте его разными словами: «нож лежит на краю доски, ближе к зрителю, ручка уходит вправо по кадру». После генерации всё равно сверьте глазами.
Стиль и материалы
Слово «реалистично» модель трактует широко. Точнее работают материалы и носитель: «матовая керамика», «масло на холсте, видны мазки», «чёрно-белая плёнка, зерно», «векторная иллюстрация, ровные контуры». Если нужна эпоха в дизайне, опишите признаки: «скруглённые формы, пастельные блоки, без градиентов» — уже инструкция, а одно «в стиле восьмидесятых» — лотерея.
Стиль не обязан быть «художественным». Формулировка «как снимок для маркетплейса, белый фон, мягкая тень под предметом, без реквизита» задаёт коммерческую задачу так же чётко, как «импрессионизм». Перечисляйте видимые признаки вместо оценок вроде «дорого» или «стильно».
Что убрать из кадра
Отрицательная часть запроса экономит время на переделках. «Без людей на заднем плане», «без текста и логотипов», «без водяного знака» — типичные строки для иллюстраций. Впрочем, работают они по-разному. У Stable Diffusion текст читает замороженный кодировщик CLIP ViT-L/14, и для запретов в библиотеке diffusers предусмотрено отдельное поле negative_prompt — «что не включать в изображение». Если у генератора есть такое поле, запреты лучше писать туда. Слово «люди» в основном запросе, даже с частицей «без», модель с простым текстовым кодировщиком иногда понимает наоборот. Генераторы, построенные на больших языковых моделях, вроде Nano Banana 2.1 на основе Gemini 3.6 Flash, читают отрицание как обычную фразу, но и у них проверяйте результат.
У Nano Banana 2.1 в карточке отдельно отмечено, что мелкий текст часто выходит размытым, а длинные абзацы и целые страницы модель не держит. Если нужна читаемая надпись, закладывайте крупный кегль и короткую фразу, а точный текст на макете проще поставить вручную в редакторе.
Как текст попадает в картинку
Для понимания нужно отступить на пять лет назад. В феврале 2021 года OpenAI выложила две работы с разницей в два дня. 24 февраля — статью о DALL·E: трансформер читал текст и картинку как один поток токенов и рисовал по подписи, которую раньше не видел. 26 февраля — статью о CLIP, модели, которую обучили сопоставлять картинки и подписи на 400 миллионах пар из интернета. 20 декабря 2021 года группа Робина Ромбаха описала латентную диффузию: слой перекрёстного внимания связывает слова запроса с областями будущего кадра на каждом шаге. Через восемь месяцев из этой работы вырос Stable Diffusion.
Для автора запроса это значит следующее. Модель не разбирает русскую грамматику как школьный учитель. Она ищет соответствия между кусками текста и типичными узорами картинок из обучения. Длинное предложение с десятью равнозначными деталями модель «услышит» хуже, чем короткие фразы с явными главными словами. Повтор одного требования пять раз требование не усиливает, а размывает остальные.
Современные генераторы к тому же часто переписывают запрос сами. В документации OpenAI сказано, что при генерации через чат-модель запрос автоматически переформулируется, и итоговую версию можно увидеть в поле revised_prompt. Для читателя это объясняет, почему два одинаковых запроса дают разные кадры: между вашей строкой и рисунком стоит ещё один пересказ.
Правка готового изображения устроена иначе — модель должна сохранить часть пикселей и заменить другую. Для правки OpenAI советует описывать изменение и отдельно то, что нужно сохранить. Маска у GPT Image, по той же документации, работает как подсказка к запросу, и точную форму выделенной области модель может не повторить. Тогда запрос описывает изменение, а не всю сцену с нуля: «оставить лицо, заменить фон на ночной город», «тот же продукт, другой ракурс». Это ближе к монтажу, чем к генерации, но те же пять слоёв работают: что трогаем, какой свет, откуда камера.
Опорное изображение не отменяет текст
Когда к запросу прикладывают исходный снимок, текст всё равно нужен. Опора задаёт композицию или лицо, а слова говорят, что изменить: «сохранить позу, заменить фон на ночной город», «оставить упаковку, сменить только цвет крышки». Без такой строки модель может перерисовать больше, чем вы хотели.
У FLUX 3 Image Klein, по анонсу Black Forest Labs от 15 октября 2026 года, можно передать до десяти опорных снимков, а рамки (bounding boxes) задают, где должен оказаться предмет или в какой области разрешена правка. Тогда запрос делится на две части — что взять с опоры и что дорисовать словами. Порядок слоёв тот же, только первый начинается со слов «сохранить», «заменить», «убрать».
Если опора — скриншот интерфейса или схема, а нужна иллюстрация для статьи, лучше не просить модель перерисовать её один в один. Опишите смысл схемы словами и постройте кадр с нуля. Иначе в кадре останутся мелкие элементы интерфейса, которые модель исказит.
Когда описание можно укоротить
Не каждый кадр требует пятистрочного запроса. Для простой иконки «одна книга на белом фоне» хватит двух слоёв: объект и запреты. Для обложки с конкретным настроением все пять окупаются — модель перестаёт подставлять случайный закат и случайный стол.
Короткий запрос уместен, когда вы готовы принять умолчания модели. Длинный — когда умолчания уже мешали в прошлых попытках. Удобно держать в заметках оба варианта, «минимальный» и «полный», и копировать из них блоки света и ракурса между задачами.
Ещё один частый случай — повторяемый кадр для бренда. Там фиксируют свет, ракурс и фон один раз, а в коротком хвосте меняют только предмет: «те же свет и фон, вместо чашки — термос», «та же композиция, другой цвет упаковки». Так не приходится переписывать простыню, и модель не уезжает в новую сцену.
Если в кадре люди, перечислите видимое: одежда, поза, что делают руки, кого в кадре быть не должно. Реалистичные портреты и «фото» человека — отдельная задача со своими правилами, её разбирает статья о том, как сгенерировать фото нейросетью.
Разбор одного запроса
Возьмём задачу, с которой приходят чаще всего: картинка к посту о домашней выпечке. Первый вариант запроса выглядит так: «красивый уютный хлеб, реалистично, высокое качество». В нём три оценки и один предмет, а света, ракурса и фона нет. Модель заполнит пустоты самыми частыми вариантами: батон по центру, ровный свет, размытая кухня за спиной. Картинка выйдет гладкой и никакой.
Теперь соберём тот же кадр по слоям.
- Объект и действие: «круглый ржаной хлеб, только из печи, корка треснула крестом, рядом половина буханки срезом к зрителю».
- Свет: «утренний свет из окна слева, низкий, тёплый, видна мука в луче».
- Ракурс: «камера на уровне стола, чуть сверху, хлеб в правой половине кадра, слева пустая доска».
- Стиль и материалы: «как снимок на плёнку, мягкое зерно, льняное полотенце, старая деревянная доска».
- Запреты: «без людей, без рук, без надписей, без других продуктов на столе».
Каждая строка закрывает одно умолчание. «Срезом к зрителю» объясняет, что половинка нужна видимой, а не спрятанной за целой буханкой. «Мука в луче» задаёт атмосферу через предмет, а не через слово «уютно». «Слева пустая доска» оставляет место под текст поста, если картинка пойдёт на обложку. Запреты отсекают типичные добавки — руку с ножом, банку варенья, вывеску пекарни.
Дальше смотрим результат и правим одну строку за раз. Хлеб получился, но свет плоский — меняем только второй слой: «свет жёстче, тень от буханки длинная, вправо». Модель добавила кружку на край стола — дописываем её в запреты. Если после третьей правки кадр снова «уехал», возвращаемся к сохранённой версии и меняем другую деталь. Так видно, какие слова модель держит стабильно, а какие игнорирует.
Этот же разбор работает для любой сцены: натюрморт, фон для слайда, иллюстрация к инструкции. Меняются только слова внутри слоёв.
Типичные ошибки в запросе
Слишком много главных героев. «Город, дракон, космический корабль и свадьба» — модель выберет два-три элемента и потеряет остальное. Разбейте на серию запросов или оставьте один сюжет.
Противоречия. «Ночь» и «яркое солнце в центре кадра» в одной фразе модель сгладит, и выйдет не то, что задумывали. Сначала решите, что важнее, и уберите второе.
Абстракции вместо видимого. «Ощущение успеха», «атмосфера стартапа» не рисуются. Замените их предметами: «пустой стол, один ноутбук, стикеры на стене, кофе остыл».
Чужие имена без контекста. Запрос «в стиле известного художника» может дать узнаваемую манеру и неожиданные артефакты. Для коммерческой работы надёжнее описывать приёмы — мазок, палитру, композицию, — а не подпись под картиной.
Ожидание точного текста в кадре. Даже модели, которые хвалят за надписи, в своих карточках и документации пишут о слабых местах: у Nano Banana 2.1 — мелкий шрифт, у GPT Image — точное размещение и чёткость текста. Крупные короткие слова иногда выходят, абзац на плакате — редко.
Забытый фон. Если фон не описан, модель часто ставит нейтральную размытую стену или случайный пейзаж. Одна фраза «фон однотонный, серо-голубой, без деталей» уже выравнивает серию кадров.
Две задачи в одной. Логотип и длинный слоган в одном запросе — это форма знака и набор букв. Модель чаще попадёт в форму, чем в текст. Разделите: сначала знак без надписи, потом правка с опорным снимком.
Как сужать запрос, если кадр плывёт
Первая попытка редко совпадает с задумкой, и это обычный режим работы, а не признак «плохой нейросети». Цикл короткий: посмотреть, что совпало, изменить одну фразу, запустить снова.
Лишние люди в кадре обычно убираются верхним слоем: «без людей, без силуэтов, без рук». Если меняется не тот предмет, усильте первый слой: «единственный объект — чашка, на столе больше ничего». Если спорит свет, не переписывайте сюжет — замените только описание лампы или окна.
Серию однотипных кадров для карусели удобнее собирать, когда свет и ракурс зафиксированы, а меняется один параметр: цвет фона, положение предмета, время года за окном. Так видно, какую часть запроса модель держит, а какая каждый раз уезжает.
Как проверить результат
Сгенерированную картинку стоит смотреть так же внимательно, как чужой монтаж, только ошибки другие.
- Мелкие детали и симметрия. У животных и людей — лапы, пальцы, зубы, серьги. У техники — кнопки, провода, колёса.
- Текст и знаки. Вывески, этикетки, цифры на циферблате. Если буквы плывут, это ограничение модели: поможет другая попытка или ручная правка, а не ещё один абзац в запросе.
- Согласованность серии. Один и тот же персонаж в двух кадрах — отдельная задача. Google в карточке Nano Banana 2.1 пишет, что согласованность персонажа между входом и выходом не всегда идеальна, а OpenAI — что GPT Image может не удержать повторяющегося героя или элементы бренда между генерациями.
- Пространство. Совпали ли «слева» и «справа» с задумкой, не сломало ли отражение в зеркале лицо или предмет.
- Вёрстка. Если кадр должен лечь в макет, сверьте положение элементов: OpenAI прямо называет точное размещение в строгих композициях слабым местом модели.
- Лишнее от модели. Водяные знаки, странные логотипы, третья рука — повод ужесточить запреты и сгенерировать заново.
Обложки и превью смотрите в уменьшенном виде: если главный силуэт не читается в маленьком размере, запрос стоит упростить. Если картинка пойдёт в печать или на проектор, проверьте её в оттенках серого — мягкие полутона, которые любят генераторы, на большом экране превращаются в кашу.
Частые сюжеты и что в них писать
Обложка статьи или поста. Один предмет-символ, спокойная левая или верхняя часть кадра под будущий заголовок, контрастный силуэт. Структура: «один объект справа от центра, тёмный фон, мягкий контровой свет, без текста, без мелких деталей». Как подбирать обложку под конкретную площадку, разбирает статья про нейросеть для обложки.
Фон для слайда. «Однотонный или с мягким градиентом, без предметов на переднем плане, без людей, без логотипов». Если нужна глубина, добавьте «лёгкое размытие, как на портретном снимке с открытой диафрагмой».
Иллюстрация к инструкции. Один шаг — один кадр. Не пересказывайте в запросе всю инструкцию: «руки держат отвёртку, крупный план, вид сверху, стол серый, без лица, без марки инструмента». Для серии шагов держите свет и фон одинаковыми, меняйте только действие.
Предмет для маркетплейса. Белый или светло-серый фон, мягкая тень под предметом, предмет по центру, без реквизита, без текста на упаковке, если текст не входит в задачу.
Сюжетная сцена без людей. Опишите следы присутствия вместо героя: «включённая настольная лампа, открытая книга, пар от чая, вечер, за окном дождь». Людей нет, а история читается.
Перед отправкой перечитайте запрос и вычеркните прилагательные без предмета: «атмосферный», «стильный», «качественный» не добавляют пикселей. Замените их светом, материалом или расстоянием до камеры. Последняя строка запроса во всех сюжетах одинакова по смыслу — что модель не имеет права добавить от себя. Это дешевле, чем десять повторов из-за лишней вывески в углу.
| Симптом на выходе | Что чаще всего не досказали в запросе |
|---|---|
| Случайный пейзаж за окном | Фон и «без деталей» |
| Плоский свет без настроения | Источник и время суток |
| Не тот масштаб | Ракурс и слова «крупный план» / «общий план» |
| Лишние люди или руки | Блок запретов |
| Размытые буквы | Слишком много текста; нужен редактор, а не новый абзац запроса |
Какие модели пробовать
Запрос к генератору подают в режиме «Картинка» в чате GPThub. Там уже доступны Nano Banana 2.1, FLUX 3 Image Klein и GPT Image 2.5 Sunburst. По карточке Google, Nano Banana 2.1 рассчитана на точную правку, инфографику и надписи на нескольких языках. FLUX 3 Image Klein по анонсу Black Forest Labs быстрая и принимает до десяти опорных снимков. GPT Image в документации OpenAI опирается на знания о предметах и умеет править по описанию. Подробности о каждой — в материале про Nano Banana 2.1, разборе FLUX 3 Image Klein и статье про GPT Image. Выбрать модель под задачу помогает гайд по выбору модели.
Рейтинга «лучшая во всём» у генераторов нет, поэтому перед серией кадров стоит отправить один и тот же запрос в две модели и сравнить, кто лучше держит именно ваши слои — свет, ракурс или запреты.
Если вы прикладываете к чату готовый снимок — скриншот, диаграмму, фото товара — и просите «объясни» или «опиши», это уже другой режим работы с файлом. Его разбирает гайд про картинки в чате. А что такое запрос к нейросети в принципе и чем он отличается от вопроса — в статье про промпт; для одного кадра контекст короче, но структура «главное, уточнения, запреты» та же.
Вопросы и ответы
Как сгенерировать картинку по описанию, если я никогда не писал запросы?
Начните с одного предмета и одного источника света. Сгенерируйте кадр, отметьте, что не совпало с задумкой, и добавьте одну уточняющую фразу во второй запрос. Не раздувайте текст до абзаца из двадцати прилагательных.
Нейросеть понимает описание картинки на русском?
Генераторы, построенные на больших языковых моделях, читают запрос тем же языковым ядром, что и чат: Nano Banana 2.1 основана на Gemini 3.6 Flash, и Google отдельно называет среди её задач надписи на нескольких языках (список языков в карточке не приводится). Если модель не слышит деталь, перефразируйте её проще или разбейте запрос на короткие предложения.
Какая нейросеть генерирует изображения точнее по тексту?
Единого победителя нет. У Nano Banana 2.1 сильные стороны — правка и инфографика, у FLUX 3 Image Klein — скорость и опорные снимки, у GPT Image — опора на знания о предметах. Сравнивайте на своей задаче двумя-тремя попытками, а не по чужому рейтингу.
Можно ли генерировать изображения без интернета?
Да, если запустить открытые веса на своём компьютере. FLUX 3 Image Klein по данным Black Forest Labs работает на видеокартах от 8 ГБ памяти в сжатой сборке INT8. Как устроен такой запуск, разбирает статья про локальную нейросеть. В браузерном чате модель работает на сервере, а от вас нужен только текст запроса.
Может ли нейросеть сделать картинку с текстом?
Иногда — крупные короткие слова. Длинные надписи и мелкий шрифт остаются слабым местом, это прямо указано в карточке Nano Banana 2.1 и в документации GPT Image. Для надёжного текста на макете планируйте ручную вёрстку.
Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Похожие статьи
- Фото нейросетью пошагово
Как сгенерировать фото нейросетью: кадр, запрос, выбор модели, проверка пальцев и света, правка без нового сюжета. Портреты и предметная съёмка.
- Генерация против фильтра
Фильтр меняет готовый снимок, нейросеть для генерации изображений рисует картинку по описанию с нуля. Как это устроено и что выбрать под задачу.
- Как нейросеть рисует
Картинка собирается из шума за десятки шагов: откуда берётся лицо и что смотреть на готовом кадре.
- Нейросеть GPT Image
GPT Image — нейросеть OpenAI для картинок. Что умеет GPT Image 2, чем версии 2.5 отличаются и что проверять в готовом кадре.
- Nano Banana 2.1
Nano Banana 2.1 — новая модель Google для картинок, вышла 6 октября 2026. Чем отличается от Nano Banana 2 и Pro и где её открыть.
- Что такое FLUX 3 Image Klein
Black Forest Labs 15 октября 2026 открыла веса FLUX 3 Image Klein. Размер, память видеокарты и условия лицензии.
Источники
- Stable Diffusion Public Release
- Stable Diffusion text-to-image pipeline
- High-Resolution Image Synthesis with Latent Diffusion Models
- Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Zero-Shot Text-to-Image Generation (DALL·E)
- Nano Banana 2.1 Model Card
- FLUX 3 Image Klein
- Images and vision
- Image generation
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Создать картинку по описанию в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.