
"Нейросеть для обложки и превью: из чего собирается картинка, на которую кликают"

Обозреватель: как устроен ИИ
Содержание
В ленте YouTube значок видео на экране телефона занимает меньше почтовой марки. Решение, смотреть или листать дальше, принимается за доли секунды, и в этот момент зритель чаще смотрит на картинку, чем читает название. Справка YouTube для авторов приводит конкретную цифру: в 90 % самых эффективных видео стоят собственные значки, загруженные автором, вместо кадров, которые сервис выбрал из ролика сам. С обложкой сообщества ВКонтакте, квадратом трека в стриминге и вертикальной обложкой электронной книги история та же. Размеры и пропорции у площадок разные, задача одна — уместить смысл в крошечный прямоугольник. Нейросеть для обложки помогает на одном участке этой работы: быстро получить основу кадра. Подогнать её под рамку площадки и дописать текст там, где буквы читаются, всё равно придётся руками. Ниже — откуда берутся пропорции, что именно рисует модель и где её работа заканчивается.
Превью и «файл обложки»
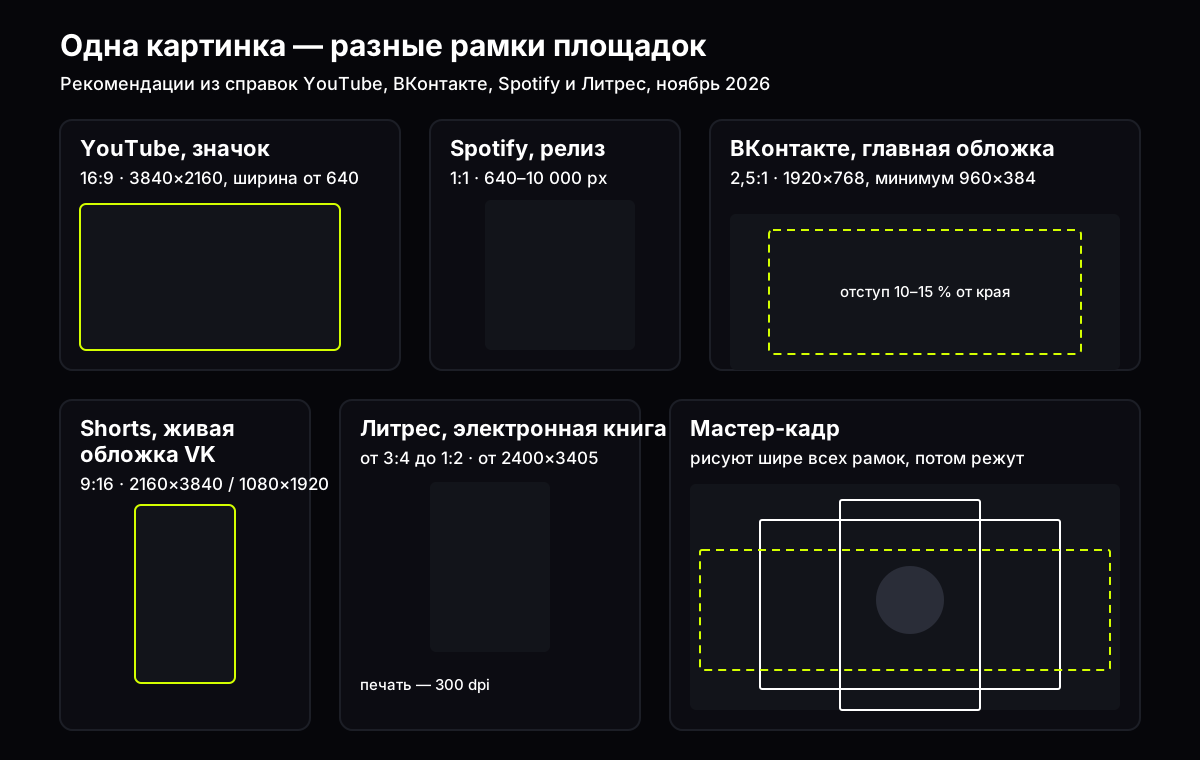
Привычная аналогия такая: обложка похожа на конверт пластинки или переплёт книги — нарисовал красиво один раз, и готово. На цифровых площадках эта аналогия ломается, потому что конверт меняет форму вместе с интерфейсом. Значок YouTube в поиске, в подписках и на главной показывается по-разному. Для вертикальных роликов сервис сам переделывает значок 16:9 в кадр 4:5 — на главной, в подписках и в рекомендациях. Обложка сообщества ВКонтакте на компьютере выглядит как широкая полоса 1920×768 пикселей, а на телефоне над ней может стоять отдельная «живая» обложка в пропорции 9:16. Квадрат релиза в Spotify и вертикальный файл книги для Литрес задают ещё две рамки.
Точнее думать про мастер-кадр и набор обрезок. Мастер-кадр — самый большой холст, на котором стоят герой и свет. Обрезки — производные под YouTube, VK, квадрат трека и книжный формат. Нейросеть удобна на этапе мастера: она быстро перебирает композиции. Рамку и место под текст она не знает, их задаёт площадка.
Нейросеть для обложки: что происходит внутри
Запрос «сделай обложку для ролика про ремонт кухни» модель понимает буквально. Ей нужен кадр, похожий на картинки из обучения, рядом с которыми встречались слова про кухню, инструменты и яркий свет. Канал она не открывает, статистику не читает и про жёлтый фон, который работает у соседа по нише, ничего не знает.
Большинство современных генераторов картинок выросли из латентной диффузии. Этот подход описали Робин Ромбах и соавторы в статье, выложенной на arXiv 20 декабря 2021 года. Их довод был практическим: диффузионные модели, которые работают прямо с пикселями, требуют для обучения сотен дней на видеокартах. Поэтому картинку сначала сжимают автокодировщиком в компактное скрытое представление, и шум снимают уже там. Текст подключается через перекрёстное внимание — механизм, который на каждом шаге подсказывает, какие участки шума во что превращать.
Несколько терминов подряд. Промпт — текстовое описание сцены. Шаг — один проход снятия шума, их обычно несколько десятков. Опорный снимок — картинка, которую подают вместе с текстом, чтобы удержать лицо, предмет или палитру. Сид — начальное состояние шума; при одинаковом сиде и тех же настройках результат повторяется, но в обычном чате его, как правило, не показывают.
Отсюда следствие для обложек. Настроение и крупный объект модель выдаёт хорошо. Слабее она там, где нужна точность: мелкий текст, логотип с тонкими линиями, точная копия вашей упаковки, лицо конкретного человека без опорного фото. По характеру работа ближе к иллюстрации, чем к вёрстке макета.
Размеры: YouTube, VK, трек, книга
Ниже цифры из официальных справок площадок на 1 ноября 2026 года.
YouTube. Свой значок для обычного видео загружают в пропорции 16:9. Справка рекомендует разрешение 3840×2160 пикселей, минимальная ширина — 640. Форматы JPG или PNG. С телефона файл значка видео не больше 2 МБ, с компьютера — до 50 МБ. Для Shorts пропорция 9:16, рекомендуемое разрешение 2160×3840, и свой значок для Shorts пока ставят только в Творческой студии на компьютере. Значок плейлиста подкаста — квадрат 1:1.
ВКонтакте. Главная обложка сообщества — PNG или JPG, минимум 960×384, рекомендуемый размер 1920×768. Справка VK даёт полезное правило: если какую-то часть обложки важно видеть всегда, отступите от неё до края на 10–15 % длины стороны. Тогда она будет видна на большинстве устройств. Живая обложка для мобильных — до пяти фото или видео. Фото 1080×1920 или другое в пропорции 9:16. Видео — MP4 (H.264/AAC), от 15 до 60 кадров в секунду, до 30 секунд и до 20 МБ.
Стриминг. Spotify для обложки релиза требует квадрат 1:1, от 640 до 10 000 пикселей по каждой стороне, TIFF, PNG или JPG со сжатием без потерь, цвет sRGB, 24 бита на пиксель. Отдельной строкой сказано не увеличивать изображения искусственно.
Книга. Литрес Авторы рекомендует для электронной книги PNG или JPG в RGB от 2400×3405 пикселей, пропорции от 3:4 до 1:2, файл до 5 МБ. Для печатной версии обложка должна быть в 300 dpi. Для аудиокниги — квадрат 3000×3000 пикселей, 300 dpi, JPG.
Одна иллюстрация «герой с инструментом» для этих случаев потребует четырёх-пяти кадрирований. Поэтому исходник у нейросети полезно просить чуть шире нужного: при обрезке не придётся резать голову или руку.
Почему цифры важнее «красоты на весь экран»
В полный рост обложку почти никто не видит. Её видят в сетке рядом с десятками чужих. Проверка на большом мониторе поэтому обманчива. Держите рядом с макетом маленькую копию шириной 120–160 пикселей и в последний момент смотрите только на неё. Если на этом размере пропал главный предмет, большее разрешение файла проблему не решит.
Из чего складывается клик
Готовой формулы кликабельности справка YouTube не даёт, зато перечисляет приёмы, которые можно проверить глазами. Выбирать как можно более крупные изображения: значки по-разному выглядят на разных устройствах. Соблюдать правило третей. Накладывать поясняющий текст и элементы бренда, но читаемым шрифтом. Для случайного зрителя работают узнаваемые эмоции и ситуации — справка в качестве примера называет лицо удивлённого человека. Совет про эмодзи и заглавные буквы в той же справке относится к названию ролика: эмодзи умеренно, название целиком капслоком не писать.
На языке запроса к нейросети это превращается в связку «один объект, один свет, один фон». Запрос «обложка для ютуба про Python» даст случайный набор символов программирования. Рабочий вариант для фона и героя выглядит так: «крупный план руки с отвёрткой на жёлтом фоне, мягкая тень, без текста, без логотипов, слева пустое место под надпись». Пустое поле слева или сверху — осознанный приём, туда потом ляжет заголовок.
Проверка перед публикацией простая. Уменьшите картинку до ширины большого пальца на экране. Если не видно, о чём ролик, кадр перегружен. Если на картинке осталась надпись, которую нарисовала модель, буквы почти наверняка искажены — их стирают и набирают заново в графическом редакторе.
Лицо, эмоция, честность кадра
Генератор может нарисовать «удивлённого человека», но это будет не ваш ведущий, пока вы не дадите опорное фото. Black Forest Labs 15 октября 2026 года выпустила FLUX 3 Image Klein — открытую модель на 5,6 млрд параметров, которая принимает до десяти опорных снимков. Это удобно, когда нужен один и тот же герой в серии. Nano Banana 2.1 от Google (карточка модели опубликована 6 октября 2026 года, основа — Gemini 3.6 Flash) принимает текст и картинки и хорошо подходит для правки готового кадра: осветлить фон, убрать лишний предмет, сменить цвет куртки. Подробные разборы — в статьях про FLUX 3 Image Klein и про Nano Banana 2.1.
Если ролик — интервью с реальным гостем, честнее взять кадр со съёмки и только подчистить фон нейросетью. Если это абстрактный разбор без лица в кадре, сгенерированный персонаж допустим, но зритель не увидит его в самом видео, и лучше, чтобы значок этого не обещал.
Текст и кириллица
Буквы — слабое место почти всех генераторов. Модель рисует форму буквы, языка она при этом не знает. На превью появляются псевдослова, смесь алфавитов, пляшущие цифры. Даже у Nano Banana 2.1 карточка модели честно пишет, что мелкий текст на размере 1K часто размыт. Для русского заголовка надёжная схема одна: нейросеть рисует только сцену, в запросе прямо сказано «без текста», название накладывают вручную. Как строить такие описания, подробно разобрано в гайде «Как писать промпты», а приёмы правки картинок в чате — в гайде «Работа с картинками».
Контраст и один акцент
На превью соседствуют десятки картинок. Фон, который на мониторе кажется благородно-серым, в ленте превращается в пятно. В запросе стоит прямо назвать контраст между героем и фоном и один цвет, который должен бросаться в глаза. Второй яркий акцент модель часто дорисовывает сама, и композиция расползается. Фирменный цвет бренда опишите словами, а точный код цвета выставьте уже в редакторе.
Как отбирать дубли
С первого раза идеальный кадр получается редко. Удобная привычка: сгенерировать три-пять вариантов с небольшими сдвигами в описании света и ракурса. Сразу отбросить кадры с лишними пальцами, кривыми надписями и мусором по углам. Оставшиеся уменьшить до размера значка и выбрать тот, где главный объект читается быстрее. Два лучших дубля полезно сравнить бок о бок именно в маленьком размере.
Как выбирать модель под задачу, а не по громкости названия, объясняет гайд «Как выбрать модель».
Серия роликов и один стиль
У канала с десятком выпусков в месяц обложки работают как обложки журнала. Зритель узнаёт полосу цвета, шрифт заголовка, место лица в кадре. Нейросеть без опоры каждый раз рисует «похоже, но не то». Поэтому для серии правила договариваются один раз и повторяются в каждом запросе.
Первое — повторять ракурс и палитру. Описание «тёплый боковой свет, тёмно-синий фон, герой справа, слева пусто под текст» звучит скучно, зато в ленте канал узнаётся с одного взгляда.
Второе — текст только в редакторе. Даже если модель однажды нарисовала удачное слово, в следующем дубле буквы поплывут.
Третье — хранить опорный кадр победившей обложки и подавать его в следующих запросах. Для этого и нужны модели с несколькими опорами.
Четвёртое — время от времени возвращаться к старым роликам, которые всё ещё приходят из поиска. YouTube в справке советует экспериментировать с обновлением старых значков, чтобы привлечь новых зрителей. Заодно видно, не устарела ли палитра.
Маркетологам, у которых обложки — часть рекламных материалов, пригодится разбор «Нейросеть для маркетологов»: там про то, как вписать генерацию в общий поток креативов.
Подкаст и аудио без видео
Кажется, что подкасту картинка не нужна. Но YouTube просит для плейлиста подкаста квадратный значок 1:1, и на других площадках выпуск тоже живёт с квадратом: в плеере, в подборках, в поиске. Запрос здесь короче, чем для ролика: один символ или предмет, мало деталей, высокий контраст. Лицо ведущего берут с опорного фото, если подкаст авторский. Для абстрактной темы лучше подходит предмет-метафора — «говорящую голову» модель нарисует с чужими чертами.
Название ролика и картинка вместе
Справка YouTube делит названия на два типа. Доступные для поиска точно описывают содержание и находят тех, кто ищет похожее. Интригующие вызывают любопытство у людей, которые сами бы тему не искали. Значок работает в паре с названием любого типа. Нейросеть ваше название не знает, пока вы не перескажете его смысл в запросе — без просьбы рисовать буквы. Порядок получается такой: сначала формулируют название, потом описывают кадр, который подтверждает его обещание. Если ролик про разбор ошибок, на значке уместны крупный инструмент или схема. Случайный улыбающийся человек к теме отношения не имеет и только сбивает.
Ошибки, которые видны только после загрузки
Слишком много текста из генератора. Даже короткое слово на фоне превращается в пятно на миниатюре. Текст убирают из запроса и набирают поверх.
Герой у самого края. На YouTube и VK края кадра съедает интерфейс, на вертикальных роликах значок вообще переделывается в 4:5. Объект сдвигают к центру и оставляют поля — те самые 10–15 % из справки VK.
Один файл на все площадки. Квадрат трека, полоса VK и вертикаль книги из одного PNG без кадрирования выглядят криво. Из мастера экспортируют отдельный файл под каждую рамку.
Растягивание маленькой картинки. Spotify прямо просит не увеличивать изображения искусственно, а Литрес задаёт нижнюю границу 2400×3405. Размытие на квадрате альбома заметнее, чем на большом мониторе. Правильнее сразу генерировать в достаточном разрешении или перегенерировать.
Забытая живая обложка VK. Главная полоса 1920×768 на телефоне не заменяет вертикальный блок 9:16. Из одного сюжета нужно два макета.
Связка с монтажом ролика
Значок и первый кадр ролика решают разные задачи. Первый кадр должен совпадать с темой, но может быть спокойнее и без текста. Значок громче: контраст, крупный объект, лицо. Многие авторы берут удачный кадр из ролика и дорабатывают его в редакторе — это честный путь, если в видео есть нужная эмоция. Нейросеть пригодится, когда такого кадра в материале нет или фон на съёмке слишком шумный. Если хочется, чтобы статичный значок продолжился движением в живой обложке VK, пригодится разбор «Как оживить фото».
Порядок такой. Сначала решают, откуда берётся основа кадра — съёмка или генерация. Потом подгоняют пропорции. Потом проверяют миниатюру и только после этого выкладывают. Обратный порядок даёт ролики с хорошим видео и слабым значком.
Практика: четыре типовых запроса
Ниже образцы формулировок и что проверять в результате. Модели для них — те же Nano Banana 2.1 и FLUX 3 Image Klein.
YouTube, обучающий ролик. Запрос: «стол сверху, блокнот, рука с карандашом, яркий однотонный фон, мягкий свет, высокий контраст, без текста, без водяных знаков, пустой угол справа сверху». Проверка: на миниатюре шириной 120 пикселей видны блокнот и рука. Заголовок крупным шрифтом добавлен в редакторе в пустой угол. Типичная ошибка — просьба «напиши на обложке слово Python»: получится кривая надпись.
Обложка трека. Запрос под квадрат: «один предмет по центру, виниловая пластинка на тёмном столе, контровой свет, мало деталей, без текста». После генерации — обрезка 1:1 и проверка, что пластинка не касается краёв. Сторона итогового файла не меньше 640 пикселей, лучше с запасом.
Сообщество VK. Запрос под широкую полосу: «панорама городского парка осенью, пустая зона по центру под текст, без людей крупным планом, без вывесок с буквами». Проверка: важное отстоит от краёв на 10–15 % стороны. Отдельно готовят вертикальный вариант 9:16 для живой обложки, иначе на телефоне выйдет чужой кроп.
Книга. Запрос: «иллюстрация к фантастическому роману, один персонаж в профиль, вертикальная композиция, место сверху под название, без текста, без объёмного макета книги». Проверка: итоговый файл не меньше 2400×3405 и в пропорциях от 3:4 до 1:2. Название и имя автора набирают типографикой поверх. В каталоге обложку увидят маленькой, на карточке книги — крупнее, так что проверяют оба масштаба.
Как читать ответ модели
Получив картинку, смотрите на четыре вещи по порядку. Первое — главный объект: он один и он крупный. Второе — пустая зона под текст осталась пустой; модели любят «украсить» её мелкими предметами. Третье — руки, пальцы и лица без искажений. Четвёртое — нет ли случайных букв на вывесках, упаковках, экранах в кадре. Если провал в одном пункте, правят только его: «то же самое, но убери предметы слева». Переписывать запрос целиком при этом незачем — удачная часть кадра может потеряться.
Когда нейросеть не главный инструмент
Есть три случая, где генерация уступает съёмке или вёрстке.
Первый — точный товар. Обложка для карточки маркетплейса показывает ваш товар, а модель нарисует похожую коробку и угадает этикетку.
Второй — права на образ. Лицо известного человека, чужой логотип, персонаж франшизы: генератор смешивает то, что видел в обучении, и результат может задеть чужие права. Что можно и чего нельзя делать с такими картинками, разобрано в статье «Права на картинку».
Третий — печать. Электронная обложка книги и макет для типографии с корешком — разные файлы. Нейросеть даст лицевую сторону, а ширину корешка считают по числу страниц и бумаге.
В остальных случаях связка «несколько вариантов от модели, один выбранный, обрезки под площадки, текст в редакторе» обычно быстрее, чем рисовать с нуля, если заложить время на отбор дублей.
YouTube и встроенная генерация значков
В Творческой студии YouTube есть инструмент «Спросить у Студии». Справка описывает его так: он анализирует содержание и темы видео и предлагает несколько вариантов значков. К запросу можно добавить видео или загрузить референсы, а потом уточнять результат следующими просьбами вроде «увеличить текст». По сути это тот же класс задач, что и у внешнего генератора, только внутри YouTube. Сравнивать варианты стоит по читаемости в маленьком размере. Внешняя нейросеть удобнее, когда нужен единый стиль канала сразу на YouTube, во ВКонтакте и в подкасте или когда хочется больше контроля над композицией.
Метаданные и повторная загрузка
Крупные разработчики всё чаще вкладывают в файл картинки сведения о происхождении — стандарт Content Credentials (C2PA). Эти метаданные говорят, откуда файл и чем его обрабатывали; правдивость изображённого они не подтверждают. При пересохранении в другой формат или сильном сжатии они часто пропадают. Подробнее о метках сгенерированных картинок — в статье «Водяной знак нейросети».
Практический вывод скучный. Храните исходник в PNG отдельно и не гоняйте финальный JPG через несколько мессенджеров перед загрузкой: каждое пересжатие добавляет мыло и полосы по краям. Лучше один раз экспортировать из мастера по файлу на каждую площадку и подписать их в папке по назначению.
Вопросы и ответы
Чем нейросеть для превью отличается от нейросети для обложек?
Механика одна и та же — генерация картинки по описанию. Меняется рамка: превью YouTube — 16:9, обложка VK — широкая полоса 1920×768, трек — квадрат. Запрос лучше сразу писать с учётом будущей обрезки.
Можно ли одним запросом получить готовую обложку для сообщества VK?
Полностью готовую — редко. Модель не знает, какую часть полосы срежет экран телефона. Надёжнее сгенерировать широкий фон с запасом, проверить отступы 10–15 % по справке VK и при необходимости сдвинуть композицию в редакторе.
Подходят ли нейросети для обложек книг?
Для иллюстрации на лицевой стороне подходят, если довести файл до требований площадки (у Литрес — от 2400×3405 пикселей) и набрать название и автора типографикой. Для печатной обложки с корешком нужен отдельный макет.
Какую модель выбрать для серии обложек в одном стиле?
Если важно удержать персонажа или предмет, берите модель с опорными снимками, например FLUX 3 Image Klein. Если нужно быстро править готовый кадр по тексту, удобна Nano Banana 2.1. Обе уже доступны в чате GPThub.
Почему на превью для ютуба текст от модели выглядит криво?
Генератор не набирает текст, он дорисовывает штрихи, похожие на буквы. На кириллице ошибки особенно заметны. Текст накладывают вручную после генерации фона.
Сколько вариантов стоит сгенерировать?
Для разового ролика обычно хватает трёх-пяти дублей с разными формулировками света и ракурса. Для серии лучше один раз зафиксировать удачный запрос и опорный кадр, иначе стиль от обложки к обложке будет плыть.
Связанные гайды
- Скрины и картинки
Как прикреплять скрины и фото в чат GPThub: какая модель видит изображения, как писать запрос и типичные ошибки. Шаблоны для UI, ошибок и документов.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Собрать обложку в чате
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.