
Что такое ChatGPT и как работает эта нейросеть простым языком

Обозреватель: как устроен ИИ
Содержание
30 ноября 2022 года OpenAI выложила пост с коротким именем ChatGPT. Внутри был образец диалога, который до сих пор лучше любого определения. Пользователь пишет, будто Христофор Колумб приехал в США в 2015 году. Чат отвечает, что Колумб умер в 1506-м и приехать в 2015-м не мог. Следом он предлагает представить обратное. Соседняя модель InstructGPT на той же фразе принимает посылку и рассказывает визит как состоявшийся. С тех пор продукт сильно изменился, о чём на той же странице теперь написано прямо. Что такое ChatGPT сегодня, проще понять, если держать в голове оба слоя: привычку продолжать текст и отдельную дрессировку, которая учит спорить с ложной посылкой.
Что такое ChatGPT
В посте 30 ноября 2022 года формулировка короткая. Обучили модель, которая ведёт разговор. Формат диалога нужен, чтобы отвечать на уточнения, признавать ошибки, оспаривать неверную посылку и отказывать в неуместной просьбе. Рядом стояло имя InstructGPT: родственная модель, которую учили выполнять инструкцию в запросе и давать развёрнутый ответ. ChatGPT назвали её собратом.
На время превью чат открыли без оплаты, и цель была прикладная — собрать, где модель сильна и где сыпется. Пост прямо относит её к серии GPT-3.5, чьё обучение закончилось в начале 2022 года. Считали на инфраструктуре Azure. Имя Codex в том же тексте уже есть, но как более ранняя модель, уроки которой вошли в меры безопасности релиза, а не как нынешнее приложение для программистов.
Сегодня под тем же названием живёт другой состав. Справка API называет chat-latest последней быстрой моделью, которую использует ChatGPT: окно 400 000 токенов, потолок ответа 128 000, знания обрезаны 20 апреля 2026 года, на вход идут текст и картинка, наружу — текст. Снимок под этим именем меняют. Для тяжёлой работы документация указывает GPT-6 Astra. Обзор безопасности Astra датирован 3 сентября 2026 года, в тот день модель начали раздавать. У неё в документации API окно 1 050 000 токенов и обрезка знаний 30 апреля 2026 года. 22 сентября 2026 года семью расширили: вышли GPT-6 Sol для сложного кода и агентной работы и GPT-6 Luna, самая экономная модель, рассчитанная на простую массовую работу. Через неделю, 29 сентября, OpenAI выпустила GPT-6.1 Sol, которая по описанию компании почти догоняет Astra в программировании и работе с компьютером. Лучшей по всем параметрам OpenAI при этом называет Astra. Sol и Luna сначала пришли в рабочий режим и Codex, в обычном режиме чата их на момент анонса не было. Разбор, где Astra впереди и где нет, уже лежит отдельно: GPT-6 Astra.
GPT-6 Astra и GPT-6.1 Sol уже доступны в чате GPThub. Рядом там же открыт DeepSeek — другая лаборатория и другая схема блоков. Как устроена смесь экспертов, разобрано в тексте про DeepSeek. Общий конвейер, о котором речь ниже, у них один: кусок за куском.
Откуда взялась привычка продолжать текст
Подробно про языковые модели вообще написано в объяснении, что такое LLM, а про нейросети с нуля — в тексте о нейросетях. Здесь хватит короткой предыстории, за пять лет до превью чата. 12 июня 2017 года восемь человек — Васвани, Шейзир, Пармар, Ускорейт, Джонс, Гомес, Кайзер и Полосухин — отправили в архив статью с названием, которое звучит как лозунг. «Внимания достаточно». До того сильные переводчики были рекуррентными или свёрточными сетями. Новая схема, трансформер, обходилась без обоих приёмов и опиралась только на механизм внимания.
На переводе WMT 2014 с английского на немецкий одна такая модель набрала 28,4 BLEU и обошла прежние результаты, включая ансамбли, больше чем на 2 пункта. С английского на французский вышло 41,8 BLEU после 3,5 суток обучения на восьми видеокартах. Цифры старые и узкие, это оценка машинного перевода, а не измерение «ума» чата. Важен сдвиг в том, как считают. Текст стали обрабатывать пачкой, а не строго шаг за шагом по времени, и обучать такую сеть стало проще распараллелить.
Дальше то же семейство схем выросло в модели, которые продолжают текст, хотя начинались как переводчики. Базовое упражнение осталось школьным: дан длинный текст, скрыт следующий кусок, нужно угадать его по предыдущим и повторить это на огромном корпусе. Числа внутри сети подкручиваются так, чтобы угадывание случалось чаще. Диалог, отказ и вежливое «я не знаю» к этому упражнению не прилагаются, их пришивают позже, отдельным контуром.
Как текст режется на куски
Токен — кусок текста, с которым модель делает один шаг. Окно — сколько таких кусков она держит сразу: вопрос, вложенный файл, уже написанный ответ. Скрытые шаги рассуждения, если они есть, тоже занимают место в расходе, хотя на экран не выходят.
Справка OpenAI описывает путь так: текст делится на токены, модель их обрабатывает, затем порождает выходные токены, и их снова склеивают в буквы. Токен бывает коротким, как один символ, и длинным, как целое слово. Пробел и запятая тоже входят в счёт. Для английского там же дана грубая линейка, не точный подсчёт: один токен — около четырёх символов, или около трёх четвертей слова, сто токенов — около 75 слов. Линейка дана для английского, на русский абзац её переносить один в один не стоит.
У рассуждающих моделей есть отдельный вид токенов. Справка называет их токенами рассуждения. Их не показывают как текст ответа, но они считаются в расходе выхода. Короткий абзац на экране может стоить дороже по счёту, чем кажется по числу букв. Путать их с человеческой мыслью не стоит: это дополнительные куски, которые модель произвела внутри, прежде чем показать фразу.
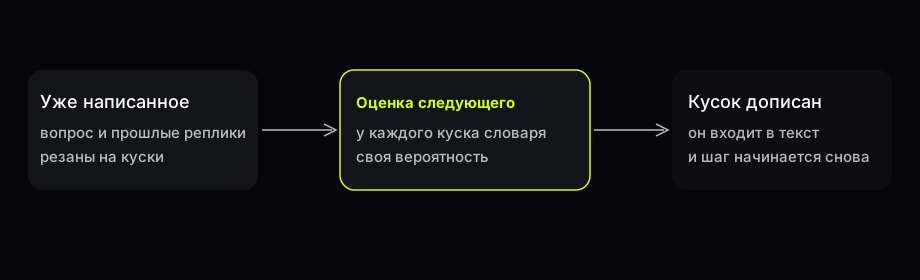
Схема одного шага, иллюстрация GPThub по справке OpenAI о токенах, ноябрь 2026
Почему чат не ищет готовую карточку
Привычная картина такая. Где-то лежит картотека ответов, чат находит нужную карточку и читает её вслух. Картина удобная и при этом неверная, потому что готовой карточки на ваш вопрос у модели нет. Есть числа, которые на каждом шаге раздают вероятности по словарю кусков. Берут один кусок — чаще тот, у кого вероятность выше, иногда соседний, если хотят разнообразия, — и приклеивают к уже написанному. Потом шаг повторяется, пока не кончится ответ или не упрётся в предел длины.
Поправка важна на практике: поиск по картотеке либо находит цитату, либо честно говорит, что карточки нет. Продолжение текста устроено иначе. Оно обязано что-то дописать, если его не научили останавливаться и отказываться. Отсюда ровный тон даже там, где опоры в вопросе не было. Разбор, почему фраза звучит уверенно и при этом мимо, лежит в статье про выдумки.
Внимание в трансформере тоже легко представить не так, потому что слово «внимание» обещает ученика, который вчитывается, а в сети это взвешенная сумма. Каждый уже увиденный кусок получает вес, и новый кусок считается из смеси предыдущих. Вес большой — кусок сильнее влияет на следующий шаг, вес крошечный — почти не влияет. Глаз у этого шага нет, считается скалярное произведение и нормализация, после чего смесь идёт дальше по слоям.
Поэтому длинный чат и длинный файл — разные нагрузки. Пока куски помещаются в окно, они могут получить вес. Когда окно кончилось, ранние реплики в этот шаг не входят. Характер модель при этом не забыла: этих кусков просто нет на входе. Проекты, о которых ниже, как раз пытаются не таскать один и тот же файл в каждое новое окно руками.
Как чат научили спорить с ложной посылкой
Базовое угадывание следующего куска даёт грамотный текст и не даёт привычки отвечать коротко на короткий вопрос или говорить «эта посылка ложная». В посте 30 ноября 2022 года расписан отдельный контур, тот же, что у InstructGPT, с другой сборкой данных.
Сначала шло обучение с учителем: тренеры писали диалоги и играли обе стороны, пользователя и помощника. Им показывали черновики, которые набросала модель, чтобы собирать ответы быстрее. Новый набор смешали со старым набором InstructGPT, который переложили в форму диалога.
Дальше собирали модель награды: брали разговоры тренеров с ботом, выбирали случайную реплику модели, просили несколько альтернативных продолжений и отдавали людям на ранжирование. По этим парам «лучше — хуже» учили отдельную сеть, которая ставит ответ выше или ниже. Затем основную модель докручивали так, чтобы награда росла. Метод в посте назван Proximal Policy Optimization, итераций было несколько.
Ограничения того превью OpenAI перечислила сама, и они до сих пор объясняют бытовые сбои.
Награде неоткуда взять внешнюю истину, и осторожную модель легко переучить так, что она откажется и от вопроса, на который могла бы ответить. Идеальная реплика зависит от того, что уже знает сеть, а не от того, что знает человек, который пишет образец. Одна и та же просьба в двух формулировках даёт разный результат: в одной модели «не знает», в другой отвечает. Тренеры любили длинные и «полные» ответы, поэтому модель стала многословной и повторяла, что она языковая модель OpenAI. На туманный вопрос она чаще угадывала намерение, чем переспрашивала. Часть вредных просьб всё равно проходила.
Образец с Колумбом как раз про второй контур. Продолжатель текста с радостью дописал бы биографию поездки 2015 года. После ранжирования чат сначала поймал дату смерти. Потом всё равно предложил поиграть в вымысел. Умение спорить с посылкой и любовь к связному рассказу жили в одной сети.
Как ChatGPT отвечает на вопрос
Путь одного вопроса в нынешней справке короткий, и его хватает, чтобы не ждать от чата картотеки.
Текст запроса, системные указания продукта и хвост переписки режутся на токены. Если приложен файл или картинка, они входят своим путём. У Astra и у быстрой модели, на которую указывает chat-latest, картинка на входе предусмотрена, наружу обе по документации отдают текст. Картинку как файл ответа эти карточки API не обещают.
Сеть прогоняет уже увиденные куски через слои внимания и получает распределение по словарю. Один кусок выбирается и приклеивается, цикл идёт, пока не выпадет признак остановки или не выбран предел длины. У рассуждающей настройки перед видимой фразой могут появиться скрытые токены рассуждения. На экран они не приходят, в расход выхода приходят.
Отсюда три бытовых следствия. Повтор того же вопроса может дать другую фразу, на шаге выбора куска есть место случайности, а пост 2022 года отдельно предупреждал, что перефразировка меняет ответ. Длинная предыстория в том же окне меняет веса внимания, и ответ уезжает в сторону последней темы. Короткий итог после долгого «обдумывания» не значит, что работы было мало. Скрытые куски в справке считаются, даже если их не показали.
Проверить это на учебном вопросе можно без специального режима. Возьмите утверждение с датой, которую легко сверить по учебнику, спросите прямо, затем спросите то же, подсунув ложную посылку, как в образце OpenAI про 2015 год. Третий заход — попросите назвать, какое предложение в вашем конспекте это подтверждает, и приложите сам конспект. Если третий ответ цитирует абзац, которого в файле нет, перед вами продолжение текста, а не поиск по странице. Как формулировать просьбу, чтобы в ней были роль, материал и форма ответа, разобрано в гайде о запросах. Какую модель звать на задачу, — в гайде о выборе.
Типичные сбои на этом пути одни и те же. Просьба без источника при вопросе о факте. Два задания в одной фразе, где второе отменяет первое. Файл длиннее окна, а вопрос стоит в начале, далеко от нужного абзаца. Ожидание, что чат переспросит, хотя старое описание продукта прямо говорит об обратном: на туманную формулировку модель додумывает цель.
Чем нынешний чат отличается от превью
Превью 2022 года было одной дообученной моделью серии GPT-3.5 и исследовательским окном, чтобы собрать ошибки. Страница анонса теперь сама отсылает к заметкам о релизах и предупреждает, что продукт с тех пор другой.
К ноябрю 2026 года внутри имени ChatGPT живут разные снимки. Быстрый, на который указывает chat-latest, держит окно 400 000 токенов и обрезку знаний 20 апреля 2026 года. Astra, по обзору безопасности от 3 сентября 2026 года, — отдельная, более тяжёлая модель. Её окно в документации API — 1 050 000 токенов, обрезка знаний — 30 апреля 2026 года, на вход текст и изображение. Усилие рассуждения у Astra в той же карточке задаётся несколькими ступенями, от низкой до максимальной. Ступень меняет, сколько скрытой работы модель готова сделать до видимой фразы. Она не меняет устройство шага, и шаг по-прежнему остаётся выбором следующего куска.
Обрезка знаний — отдельная дата, и её часто путают с календарём на стене. Модель не начинает «знать новости до вчера» только потому, что чат открыт сегодня. Всё, что случилось после даты обрезки, попадает в ответ, если его принесли в окне: ссылкой, файлом, включённым поиском. Без этого источника сеть продолжит текст по тому, что видела на обучении, и сделает это тем же уверенным тоном.
Имя Codex в посте 2022 года и имя Codex в продуктах 2026 года лучше не склеивать. В ноябре 2022-го так называли прежнюю модель, на которой обкатывали меры безопасности. Весной и летом 2026-го так называется набор инструментов для разработки, привязанный к учётной записи чата. Об этом следующий раздел.
Что такое Codex в ChatGPT
16 апреля 2026 года OpenAI описала большое обновление Codex. В тексте сказано, что каждую неделю им пользуются больше трёх миллионов разработчиков и что с запуска этого Codex прошёл примерно год. С того дня Codex умеет действовать на компьютере рядом с человеком, работать с большим числом привычных приложений, порождать изображения, помнить предпочтения, учитывать прошлые действия и брать повторяющиеся задачи. В настольном приложении появились разбор комментариев к правкам, несколько вкладок терминала, подключение к удалённой среде по SSH (тогда в раннем доступе) и встроенный браузер. Раскатка шла на тех, кто входит в настольное приложение учётной записью ChatGPT. Управление компьютером сначала включили на macOS. Память и подсказки с учётом контекста для части регионов и организаций в том же тексте стояли как ближайший, ещё не общий шаг.
Страница продукта делит Codex на три поверхности, и все они сидят на учётной записи ChatGPT. В терминале это командная строка, в редакторе кода — расширение (в списке названы VS Code, Cursor и другие). В облаке Codex поднимает репозиторий в изолированной среде, а человек смотрит получившийся код и решает, вливать ли его. Это уже другой масштаб, чем просьба «ответь абзацем»: у инструмента есть доступ к файлам проекта и к командам, поэтому ошибка в просьбе стоит дороже, чем кривая фраза в чате.
Академия OpenAI 23 апреля 2026 года описывает старт проще. Скачать настольное приложение, войти той же учётной записью, открыть тред. Тред устроен как чат (реплика, ответ, реплика), а проекты и история лежат слева. Проект здесь — папка на диске, не путать с проектами внутри самого чата. Совет со страницы приземлённый: первая задача должна быть короткой и полезной, разложить заметки, почистить небольшую таблицу, сравнить два черновика. Модель берут рекомендованную по умолчанию, а на трудной задаче усиливают рассуждение, то есть разрешают больше скрытых шагов до ответа.
Если вы пишете код к зачёту, разница практическая. В обычном чате модель дописывает текст программы, а запускаете вы. В Codex просьба может дойти до правки файлов и прогона команд. Проверять всё равно человеку, потому что прошедший тест и объяснение, которое совпало с условием задачи, — разные вещи. Просить лучше так: «покажи, какой тест отличает верный ответ от почти верного, и не меняй файлы, пока я не подтвержу». Вторая формулировка ближе к тому, как устроен шаг модели: она продолжает текст, а границу, где продолжение становится правкой на диске, задаёте вы.
Что такое режим разработчика
Запрос «режим разработчика» часто путают с секретной командой, которая снимает ограничения. Справка OpenAI описывает другое: режим разработчика нужен организации, чтобы собирать, проверять и публиковать свои приложения. Через них чат делает действия во внутренних инструментах: читает записи и меняет их. Протокол, на котором это собрано, в справке назван MCP.
Полная поддержка таких действий на момент обновления справки шла бетой и только в веб-версии, для рабочих и учебных пространств. Включает режим администратор или владелец пространства, он же решает, какое приложение после проверки увидят остальные, и обычный переключатель в личном чате этого не заменяет. Если пункта нет, его не прячет секретная фраза: пространство и роль этого просто не дают.
Отдельный смысл у слова «разработчик» в Codex, и его тоже стоит держать рядом, чтобы не смешать. Там разработчик — человек, который правит код через терминал, редактор или облачную среду. Режим разработчика в чате — про подключение приложений организации. Общего между ними только учётная запись и то, что оба контура в итоге зовут модель продолжать текст, а затем исполняют выбранное действие уже вне модели.
По справке OpenAI, перед записью во внешнюю систему такие приложения просят явное подтверждение. Это прямое следствие устройства, о котором речь с самого начала. Модель обязана предложить следующий шаг, а шаг, который меняет чужие данные, без человека в середине слишком похож на дописывание «и тогда запись обновилась» — фразу, которая звучит гладко и может быть ложной. Подтверждение выносит выбор из распределения вероятностей обратно к человеку.
Что такое проекты в ChatGPT
Проекты в справке — способ держать связанные чаты, файлы и инструкции вместе. Чат опирается на этот набор в долгой работе: текст, разбор, план. Доступны они вошедшим пользователям, с оговоркой про настройки пространства. Число проектов справка не ограничивает, ограничено только число файлов внутри одного.
Учебный пример там же, без лишней обвязки: кладёте материалы курса и просите конспект к зачёту или вопросы для тренировки. Инструкции проекта задаются в его настройках, действуют только внутри и перекрывают общие пользовательские инструкции. Образец формулировки в справке короткий: веди себя как наставник, будь краток, отвечай пунктами, задавай уточнения. Для семинара полезнее своя версия. «Опирайся на приложенный конспект. Если факта в файле нет, так и напиши. Не добавляй даты, которых в тексте нет».
Файлы — документы, таблицы, изображения или вставленный текст. Сколько их влезет в один проект, зависит от подписки. Справка называет три порога: 5, 25 и 40 файлов. За один раз загружают не больше десяти.
Память бывает двух видов: обычная подмешивает сохранённые заметки аккаунта, память «только проект» их не берёт. Чаты внутри видят другие разговоры этого проекта и не видят разговоры снаружи. Обратное тоже верно: внешний чат не подтягивает проект. Общий проект всегда сидит на памяти «только проект», переключить его нельзя. Смена настройки у личного проекта может занять несколько часов. Это снова про окно: проект не делает модель всеведущей, он заранее кладёт рядом те куски, которые вы готовы пустить в следующий шаг, и отсекает чужие.
Общий доступ есть на сайте и в мобильных приложениях. Право на переписку даёт читать чаты, файлы и инструкции. Право на правку меняет инструкции и файлы, даёт звать ещё людей и не даёт выгонять уже приглашённых. Владелец может удалить проект целиком, и удаление стирает чаты, инструкции и файлы, которые лежали только там (копии в отдельных библиотеках остаются). Участники теряют доступ, отмены нет. С систем OpenAI такое стирается в пределах 30 дней, если нет удержания по закону или по безопасности.
Два ограничения легко пропустить: учебный режим и запланированные учебные часы на разговоры внутри проекта не распространяются. Чат, начатый с отдельным пользовательским ботом GPT, в проект не переносится. Если пункта «перенести» нет, проще начать новый разговор уже внутри проекта.
Для личных аккаунтов содержимое общего проекта может идти в улучшение моделей, но только когда переключатель «улучшать модель для всех» включён и у владельца, и у каждого участника. Для рабочих и учебных пространств справка говорит обратное по умолчанию: их содержимое в обучение не берут. Перед тем как класть в проект чужой конспект или чужие данные, это различие стоит прочитать в настройках, а не выводить из устройства трансформера. Архитектура тут ни при чём, решает переключатель продукта.
Что проверять в ответе
Схема с кусками даёт простой список проверки, и он не требует заглядывать в веса.
Сверьте имена, даты и числа по источнику, который вы сами открыли. Модель дописывает правдоподобный следующий кусок, а пост 2022 года прямо называл правдоподобный неверный ответ известной слабостью. Один удачный абзац эту слабость не отменяет.
Попросите опору на приложенный текст и посмотрите, есть ли цитата в файле. Если цитаты нет, а тон уверенный, перед вами продолжение, не поиск.
Задайте ту же просьбу короче и с другой ложной деталью. Сильный разъезд двух ответов — повод открыть источник, а не усреднять формулировки. Чувствительность к формулировке описана в первом же анонсе.
На коде смотрите на запуск, потому что комментарий над функцией сам по себе ничего не доказывает: Codex и обычный чат оба могут написать функцию, которая читается гладко и падает на краевом входе. Тест, который вы поняли, полезнее абзаца с объяснением.
Не кладите в один проект всё подряд в надежде, что окно «само разберётся». Пороги файлов в справке конечные, окно модели тоже конечное. Пять страниц по теме вопроса обычно полезнее сорока слабо связанных.
Перед зачётом можно сделать так. Откройте чат GPThub, приложите конспект и попросите десять вопросов только по этому файлу, с ответом на следующей строке и с номером абзаца. Потом закройте ответы и пройдите вопросы сами. Расхождение с абзацем — ваш вопрос к конспекту, не к «мнению нейросети».
Коротко о бытовых именах
Слова вокруг чата разъехались, поэтому соберу их в одном месте.
Чат — сам разговор в окне. Проект — папка чатов, файлов и инструкций с отдельной памятью. Codex — инструмент для кода на той же учётной записи, с терминалом, редактором и облачной средой. Режим разработчика — включение приложений организации в веб-версии, его ставит администратор. Быстрая модель, Astra, Sol и Luna — разные модели под одной маркой, с разным окном, назначением и датой обрезки знаний. Токен — кусок, которым считается и вопрос, и ответ, и скрытые шаги.
Ни одно из этих имён не превращает следующий шаг в поиск по энциклопедии. Меняется только то, какие куски попадают в окно и какие действия после выбранного куска разрешено сделать снаружи.
Вопросы и ответы
Что такое ChatGPT простыми словами?
Это диалоговый продукт OpenAI. Вы пишете реплику, модель дописывает следующую — кусок за куском, — и так собирается ответ. Первое публичное превью открыли 30 ноября 2022 года. К ноябрю 2026 года внутри того же имени работают более новые модели, включая GPT-6 Astra от 3 сентября 2026 года и GPT-6 Sol и Luna от 22 сентября.
Что такое Codex в ChatGPT?
Codex сейчас — набор инструментов для разработки, который входит через учётную запись чата. Есть командная строка, расширение редактора и облачная среда. 16 апреля 2026 года OpenAI писала, что им пользуются больше трёх миллионов разработчиков в неделю. Старое упоминание Codex в анонсе чата 2022 года — про прежнюю модель, не про это приложение.
Что такое режим разработчика в ChatGPT?
Это режим веб-версии для рабочих и учебных пространств. В нём администратор проверяет и публикует приложения, через которые чат читает и меняет данные во внутренних системах. Секретной команды, которая «открывает скрытые возможности» личного чата, справка под этим именем не описывает.
Что такое проекты в ChatGPT?
Проект собирает чаты, файлы и инструкции по одной теме. Инструкции проекта перекрывают общие. Можно включить память только внутри проекта, чтобы внешние заметки аккаунта не подмешивались. Общий проект всегда работает так. Число проектов не ограничено, число файлов в одном — да: в справке стоят пороги 5, 25 и 40.
Как ChatGPT отвечает на вопросы?
Запрос режется на токены. Сеть оценивает, какой следующий кусок вероятнее, дописывает его и повторяет шаг. Если включено рассуждение, часть кусков тратится на скрытую работу и в ответ не попадает. Готовой карточки с ответом у модели нет.
Что такое чат ChatGPT и чем он отличается от проекта?
Чат — одна переписка. Проект — несколько таких переписок плюс общие файлы и общая инструкция. Новый чат внутри проекта наследует этот набор. Чат снаружи проекта файлы проекта не видит, если память проекта от него закрыта.
Связанные модели


Связанные гайды
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
Ещё по теме
Источники
- Introducing ChatGPT, OpenAI, 30 ноября 2022
- Attention Is All You Need, arXiv:1706.03762, 12 июня 2017
- Токены, справка OpenAI
- chat-latest, документация API
- GPT-6 Astra, документация API
- Safety overview: GPT-6 Astra, 3 сентября 2026
- Introducing GPT-6 Sol and Luna, 22 сентября 2026
- Introducing GPT-6.1 Sol, 29 сентября 2026
- Codex for (almost) everything, 16 апреля 2026
- Codex, страница продукта
- Как начать с ChatGPT Codex, 23 апреля 2026
- Режим разработчика и приложения MCP
- Проекты в ChatGPT
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.