Введение в искусственный интеллект простыми словами
Обозреватель: как устроен ИИ
Содержание
11 мая 1997 года в Нью-Йорке Гарри Каспаров сдал шестую, решающую партию матча против компьютера Deep Blue компании IBM — после 19-го хода белых. Матч закончился со счётом 3,5 на 2,5 в пользу машины. IBM на странице своей истории называет это первым случаем, когда компьютер победил действующего чемпиона мира в шахматах при стандартном турнирном контроле времени. Газеты писали о машине, которая думает как человек. Внутри не было ни сознания, ни интуиции — был перебор около 200 миллионов позиций в секунду на 32 процессорах и функция оценки позиции, которую годами настраивали люди. С этой партии удобно начинать введение в искусственный интеллект: поле шире, чем одна нейросеть в чате, и намного старше ChatGPT.
Что такое искусственный интеллект простыми словами
Привычное объяснение — «компьютер, который думает как человек». Оно удобно и неточно. IBM в справочном разделе Think (страница обновлена 2 октября 2026 года) определяет искусственный интеллект как технологию, которая даёт компьютерам и машинам имитировать человеческое обучение, понимание, решение задач, принятие решений, творчество и самостоятельность. Ключевое слово здесь «имитировать». Программа может выиграть партию или написать связный абзац, не обладая ни сознанием, ни интуицией в биологическом смысле.
Рабочее определение для конспекта собирается из трёх частей. Задача — то, что система должна уметь: ответить на вопрос, найти путь на карте, поставить диагноз по симптомам, нарисовать картинку. Метод — как это делается: правила «если — то», перебор ходов, обучение на примерах. Мера успеха — как понять, что получилось: выигрыш, точность, оценка человека.
Том Митчелл в учебнике 1997 года дал определение, которое цитируют до сих пор: программа учится на опыте E относительно класса задач T и меры качества P, если с ростом E показатель P на задачах из T улучшается. Формально это определение машинного обучения, но оно хорошо отделяет «просто код» от кода, который становится лучше от данных.
В бытовой речи ИИ часто сужают до «нейросети в браузере». IBM рисует другую картину — набор вложенных понятий, которые появлялись больше 70 лет. Внешний круг — искусственный интеллект. Прямо под ним машинное обучение, внутри него глубокое обучение на многослойных сетях, а генеративные модели, которые пишут текст и рисуют, — это модели глубокого обучения, создающие новый контент. Снаружи круга машинного обучения остаются системы на правилах и на поиске, как тот же Deep Blue.
Методы искусственного интеллекта
Запрос «методы искусственного интеллекта» в учебниках обычно раскладывают на семейства. Ниже те, которые стоит знать до того, как углубляться в чаты.
Системы на правилах. Программист или эксперт записывает цепочки вида «если температура выше 38 и кашель длится больше недели, предложить очный осмотр». Логика прозрачна, а ошибка чаще всего кроется в неполном списке правил. Таблица примеров для обучения не нужна, зато нужно время специалиста на формулировки.
Экспертные системы — следующий шаг: правила собраны в базу знаний, а отдельный механизм вывода сопоставляет с ними факты о пациенте или объекте. Классический пример — MYCIN, которую пять-шесть лет разрабатывали в Стэнфорде в начале 1970-х. Это была докторская работа Эдварда Шортлиффа под руководством Брюса Бьюкенена, Стэнли Коэна и других, написанная на Лиспе. База знаний содержала около 600 правил. Программа задавала врачу длинную серию простых вопросов, а на выходе давала список вероятных бактерий-возбудителей, ранжированный по вероятности, с уровнем уверенности, объяснением и рекомендованным лечением. Врач мог спросить, почему она задаёт этот вопрос и как пришла к выводу.
Поиск и планирование. Задача — найти последовательность шагов: ходы в шахматах, маршрут, план действий робота. Алгоритм строит дерево вариантов и отсекает заведомо худшие ветки. В учебниках здесь появляются A* и минимакс: один игрок максимизирует оценку позиции, другой минимизирует, программа заглядывает на несколько полуходов вперёд. Deep Blue сочетал такой перебор с оценкой позиции и параллельными вычислениями. Отсюда важный вывод: победа в игре не обязана идти через нейросеть, хватает хорошей функции оценки и дисциплины перебора.
Машинное обучение устроено иначе: программа настраивает числа-параметры по данным — письма «спам / не спам», фото с цифрой, тексты с продолжением. При обучении с учителем у каждого примера есть правильная метка, при обучении без учителя меток нет, и алгоритм ищет группы похожих объектов. Обучение с подкреплением — отдельная ветка: программа получает награду или штраф за действие. Алгоритмы бывают и без нейросетей — деревья решений, метод опорных векторов. Подробно эта часть разобрана в статье про машинное обучение.
Глубокое обучение. Много слоёв в нейросети и большие наборы данных. Прорыв в распознавании изображений пришёл в 2012 году, прорыв в текстовых чатах — после появления архитектуры трансформер и огромных корпусов текста. Премию Тьюринга за 2018 год за эту линию получили Йошуа Бенджио, Джеффри Хинтон и Ян Лекун.
| Метод | Откуда берётся «ум» | Типичный пример |
|---|---|---|
| Правила | Эксперт пишет «если — то» | Простой медицинский опросник |
| Экспертная система | База правил и механизм вывода | MYCIN, 1970-е |
| Поиск | Перебор и эвристики | Шахматные программы до эры глубоких сетей |
| Машинное обучение | Параметры из данных | Фильтр спама, оценка риска |
| Глубокое обучение | Многослойная нейросеть | Распознавание лиц, большие языковые модели |
Одна задача, три способа её решить
Разницу между методами проще увидеть на одной бытовой задаче — отличить спам от обычного письма.
Система на правилах начинает со списка, который пишет человек. Если в теме есть «вы выиграли», а отправитель не из адресной книги, письмо уходит в спам. Если в тексте больше трёх ссылок на незнакомые домены — тоже. Достоинство очевидно: на вопрос «почему письмо попало в спам?» есть точный ответ, номер сработавшего правила. Недостаток тоже: рассыльщики быстро учатся писать «вы вьиграли», и список приходится дописывать бесконечно.
Машинное обучение меняет источник знаний. Человек больше не пишет правила, он размечает примеры: десять тысяч писем с пометкой «спам» и десять тысяч без неё. Алгоритм сам подбирает, какие слова, ссылки и признаки отправителя чаще встречаются в каждой группе, и выдаёт для нового письма вероятность. Новая уловка рассыльщиков ловится, когда такие письма попадают в разметку. Объяснение «почему» становится размытым: модель скажет, какие признаки весили больше всего, но короткого правила уже нет.
Большая языковая модель в чате решает ту же задачу третьим способом. Ей не нужна отдельная разметка под спам: достаточно вставить письмо и спросить, похоже ли оно на мошенничество и почему. Ответ будет развёрнутым и часто разумным, потому что модель видела при обучении огромное количество текстов, в том числе о мошеннических рассылках. Зато она может уверенно ошибиться на письме от вашего настоящего банка, а одинаковый вопрос иногда даёт разные ответы.
Ни один способ не «правильнее» другого. На практике способы сочетают: правила отсекают очевидное, обученный классификатор решает массовые случаи, а спорное письмо можно показать языковой модели и прочитать её объяснение. Это и есть практический смысл карты методов: каждый из них закрывает свою часть задачи.
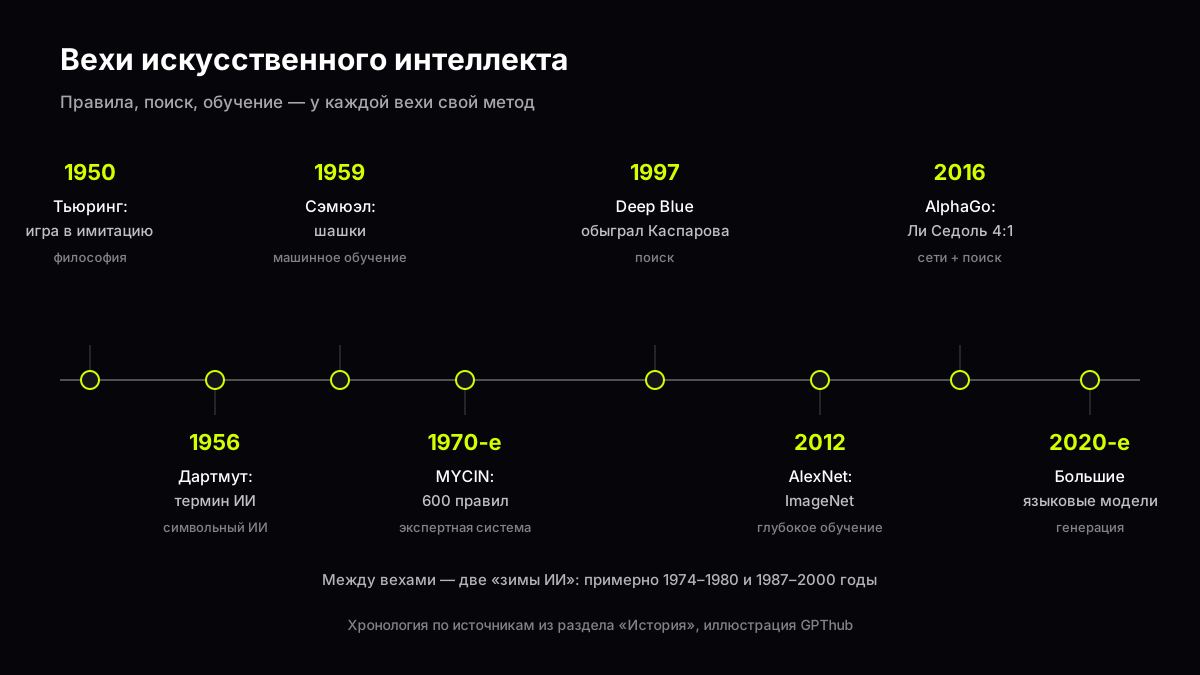
Хронология по источникам из раздела «История», иллюстрация GPThub
История искусственного интеллекта по датам
Прежде чем запоминать модные имена 2020-х, полезно выстроить линию.
1950. Алан Тьюринг публикует в журнале Mind статью «Вычислительные машины и разум» (Computing Machinery and Intelligence). В ней описана «игра в имитацию», которую позже назвали тестом Тьюринга: может ли собеседник отличить человека от машины по переписке. Это философская рамка, готовой программы в статье нет.
1955–1956. 31 августа 1955 года Джон Маккарти, Марвин Минский, Натаниэль Рочестер и Клод Шеннон подают заявку на летний исследовательский семинар в Дартмутском колледже. В этом тексте впервые появляется термин artificial intelligence, а амбиция сформулирована с размахом: любой аспект обучения или другой черты интеллекта в принципе можно описать так точно, что машина сможет его воспроизвести. Семинар прошёл летом 1956 года и, по заметкам Рэя Соломоноффа, занял около восьми недель. Аллен Ньюэлл и Герберт Саймон привезли туда программу Logic Theorist, которая доказала 38 из первых 52 теорем второй главы «Principia Mathematica» Уайтхеда и Рассела. Приняли её, по воспоминаниям, прохладно.
1950-е. Артур Сэмюэл в IBM пишет первую программу для игры в шашки на компьютере IBM 701 и учит её улучшать оценку позиции на сыгранных партиях. В 1959 году он вводит термин «машинное обучение».
1964–1967. Джозеф Вейценбаум в MIT создаёт ELIZA. Самый известный сценарий программы, DOCTOR, изображал психотерапевта, который возвращает собеседнику его же слова в виде вопросов. Вейценбаума удивило, что люди, включая его секретаря, приписывали программе человеческие чувства. Позже это назвали эффектом ELIZA.
Начало 1970-х. В Стэнфорде создают MYCIN. В проверке, которую провела Стэнфордская медицинская школа, рекомендации программы получили 65% приемлемости — сопоставимо с 42,5–62,5% у пяти преподавателей.
1997. Deep Blue выигрывает матч у Каспарова. Символический момент для прессы и технически триумф поиска и параллельных вычислений, без нейросети в центре.
2012. 30 сентября сеть AlexNet подают на соревнование ImageNet. Ошибка top-5 составила 15,3%, на 10,8 процентного пункта меньше, чем у второго места. После этого глубокие свёрточные сети стали стандартом в распознавании изображений. Почему это случилось именно тогда — данные, видеокарты, приёмы обучения — разобрано в статьях про нейросеть и про компьютерное зрение.
Март 2016. AlphaGo компании DeepMind выигрывает в Сеуле матч у Ли Седоля со счётом 4:1. Го долго считали слишком сложной игрой для перебора, и система сочетала глубокие сети с поиском по дереву ходов.
2020-е. Большие языковые модели выводят глубокое обучение в массовый чат. Устройство таких моделей разобрано в статье «Что такое LLM». Здесь достаточно помнить, что это следующий виток после AlexNet и AlphaGo, и он не исчерпывает весь ИИ.
Зимы ИИ: почему обещания расходились с результатом
Историю ИИ часто рисуют прямой линией вверх. На деле было два длинных провала, которые сами исследователи назвали «зимами». Википедия датирует их примерно 1974–1980 и 1987–2000 годами.
Первую зиму во многом открыл доклад сэра Джеймса Лайтхилла, который в 1973 году заказал британский парламент. Доклад критиковал полный провал ИИ в достижении его «грандиозных целей» и указывал на комбинаторный взрыв: число вариантов растёт так быстро, что перебор захлёбывается на реальных задачах. Последствия оказались жёсткими — исследования ИИ в Великобритании почти свернули, работу продолжили лишь Эдинбург, Эссекс и Сассекс. Крупное финансирование вернулось только в 1983 году с программой Alvey.
Вторая зима пришла после бума экспертных систем. В 1980-е они казались коммерческим будущим отрасли: оболочки вроде EMYCIN («существенная MYCIN») позволяли переносить механизм вывода в новую область без медицинских знаний внутри. В 1987 году рухнул рынок специализированных лисп-машин: дешёвые универсальные компьютеры Sun, Apple и IBM сделали их ненужными, и целую отрасль стоимостью полмиллиарда долларов заменили за один год. Японский проект «Пятое поколение», на который в 1981 году выделили 850 миллионов долларов, к 1991 году своих целей не достиг и был закрыт 1 июня 1992 года.
Сам термин «зима ИИ» прозвучал в 1984 году на панели ежегодной конференции AAAI. Исследователи, пережившие спад 1970-х, среди них Роджер Шенк, предупреждали бизнес, что энтузиазм вышел из-под контроля, и сравнивали возможные последствия с ядерной зимой. Предупреждение сбылось через три года. Урок для читателя новостей простой: громкие сроки в пресс-релизах — давняя традиция отрасли, и сверять их стоит с тем, что потом реально заработало.
Символьный ИИ и нейросети: две волны
Линию правил, экспертных систем и доказательства теорем часто называют символьным ИИ: знание явно записано, каждый шаг вывода можно проследить. Нейросети в те же десятилетия были слабее на практике — мало данных, мало вычислений, трудно обучать глубокие слои.
Ситуация перевернулась после 2012 года. Символьные методы при этом не исчезли. В гибридных системах правила проверяют выход нейросети, а в медицине и праве по-прежнему ценят объяснимость в духе MYCIN, где на вопрос «почему?» программа показывала сработавшее правило.
Полезно держать в голове две проверки. Первая — объяснимость: можно ли показать цепочку решения эксперту. Вторая — данные: нужен ли большой размеченный набор или достаточно правил. Нейросетевой чат плохо проходит первую проверку на уровне отдельного ответа, зато справляется с задачами, где правила не перечислить: перевод, пересказ, черновик текста.
Почему MYCIN так и не стала больничным инструментом, тоже поучительно. Википедия подчёркивает, что дело было не в слабости результатов. Часть наблюдателей беспокоила ответственность врача, если система ошибётся, но главной причиной называют тогдашнее состояние технологий интеграции: MYCIN была отдельной программой, куда всё о пациенте приходилось вводить вручную. С чатами логика похожая — черновик конспекта они помогают написать, но медицинскую карту не подписывают.
Слабый и сильный ИИ
Ещё один частый экзаменационный вопрос — чем слабый ИИ отличается от сильного. IBM формулирует так. Слабый, или узкий, ИИ — системы, созданные для конкретной задачи или набора задач: шахматы, фильтр спама, распознавание номеров на камере, генерация текста. Сильный, или общий, ИИ (AGI) — система, которая понимала бы, училась и применяла знания в широком круге задач на уровне человека или выше. IBM прямо пишет, что такой уровень пока остаётся теоретическим.
Ни Deep Blue, ни AlexNet, ни современный чат под определение сильного ИИ не подходят — у каждого свой узкий успех. Путаница возникает, когда маркетинг называет чат «универсальным», хотя модель по-прежнему ошибается в датах и арифметике, если ответ не проверять. Почему так происходит, разобрано в статье о том, почему нейросеть выдумывает.
Генеративный ИИ — отдельный слой поверх глубокого обучения: модели, которые создают новый текст, изображение или звук. Чем он отличается от модели, которая только классифицирует, подробно разобрано в статье про генеративный ИИ. Система распознавания номеров ничего не генерирует и при этом остаётся ИИ. Поэтому заголовки «ИИ заменит все профессии» смешивают разные уровни, и разбирать их лучше по задачам, как в статье «Заменит ли нейросеть человека».
Тест Тьюринга и почему он не экзамен
Статья Тьюринга 1950 года предложила не определение души, а игру. Судья переписывается вслепую с человеком и машиной. Если он не может их различить, можно ли говорить, что машина мыслит? Философы спорят до сих пор.
Эффект ELIZA показал оборотную сторону ещё в 1960-х: люди охотно приписывают понимание очень простой программе. В 2025 году Кэмерон Джонс и Бенджамин Берген из Калифорнийского университета в Сан-Диего провели два предварительно зарегистрированных эксперимента с классическим тестом на троих: собеседник пять минут переписывался одновременно с человеком и с программой. GPT-4.5 с инструкцией изображать определённого человека признали человеком в 73% случаев — чаще, чем настоящих людей. Без такой инструкции модель тест не проходила, а ELIZA набрала 23%.
Вывод для курса двоякий. Тест измеряет, насколько убедительно программа ведёт короткий разговор, и только. Практичнее критерий Митчелла: улучшается ли мера качества P на задаче T, когда растёт опыт E. Современный чат пишет всё убедительнее, но может «галлюцинировать» цитаты, и тогда мера качества на фактах падает, даже если текст звучит по-человечески.
Как проверить ответ модели на практике
Теория без пробы быстро забывается, остаются только лозунги. В чате GPThub уже доступны, например, Gemini 3.8 Flash и DeepSeek V4 Flash — на них удобно проверить, как модель ведёт себя на простых вопросах из курса. Учебник это не заменит, но внимательность натренирует.
Запрос 1. «Перечисли пять методов искусственного интеллекта и приведи по одному примеру на каждый». Что проверить: есть ли правила, экспертные системы, поиск, машинное обучение и глубокое обучение, не сводит ли модель всё к нейросетям. Типичная ошибка — пропуск символьных методов или подмена дат. Попросите указать год Deep Blue или AlexNet и сверьте с разделом «История».
Запрос 2. «Объясни разницу между искусственным интеллектом, машинным обучением и глубоким обучением для первокурсника». Что проверить: вложенность понятий, три слова не синонимы. Типичная ошибка — фраза «машинное обучение — это ChatGPT». Напомните модели про фильтр спама и деревья решений.
Запрос 3. «Кто победил в матче Deep Blue против Каспарова, когда это было и почему это не доказывает, что машина сознательна?» Что проверить: 1997 год, счёт 3,5 на 2,5, перебор позиций. Типичная ошибка — перенос даты на 2016 год (это уже AlphaGo) или романтизация «мысли» машины.
Запрос 4. «Составь таблицу с колонками событие, год и метод ИИ для Дартмутского семинара, MYCIN, AlexNet и AlphaGo». Что проверить: четыре строки и разные методы. Типичная ошибка — смешать MYCIN и Deep Blue в один «шахматный» блок.
Запрос 5. «Опиши экспертную систему MYCIN: когда, зачем и почему её не внедрили в больницах». Что проверить: начало 1970-х, Стэнфорд, правила про антибактериальную терапию, проблема интеграции, никакой «нейросети». Типичная ошибка — приписать MYCIN заслуги Deep Blue или наоборот.
Запрос 6. «Когда были зимы ИИ и что их вызвало?» Что проверить: доклад Лайтхилла 1973 года, обвал рынка лисп-машин в 1987 году, примерные границы двух периодов. Типичная ошибка — одна «зима» вместо двух или выдуманные цифры финансирования.
Медицинские, юридические и финансовые выводы модели нельзя принимать как консультацию специалиста, даже если тон уверенный.
После серии запросов сохраните один ответ модели и отметьте три места, где без учебника или первичного источника вы бы не поставили галочку. Это и есть навык, который отличает «пользовался чатом» от «понял введение в ИИ».
Что читать дальше
После этой статьи логичный порядок такой: нейросеть, затем машинное обучение, затем большие языковые модели. Для зрения — компьютерное зрение, для генерации — генеративный ИИ.
В новостной ленте слово «ИИ» часто означает только генеративный чат. Каждый раз стоит уточнять, о чём речь: о новой модели, о регулировании, о роботе или о классическом методе, который просто переименовали для пресс-релиза. История зим подсказывает ещё один вопрос — что из обещанного уже работает у реальных пользователей.
В конспекте полезно оставить одну строку «метод — пример — год». Так связь между разделами «Методы» и «История» видна без шпаргалки на десять страниц. Если преподаватель просит определение, начните с задачи и меры успеха по Митчеллу — это звучит академично и не требует списка моделей 2026 года.
Вопросы и ответы
Что такое искусственный интеллект одной фразой?
Это область, где программы решают задачи, требующие гибкости — ответить, распознать, спланировать, сыграть, — с помощью правил, поиска или обучения на данных. Определение IBM подчёркивает имитацию человеческих способностей, наличие сознания для этого не нужно.
Какие методы искусственного интеллекта нужно знать первым делом?
Правила и экспертные системы, поиск по дереву вариантов, машинное обучение без нейросетей, глубокое обучение и генеративные модели. Пять строк таблицы выше закрывают типовой минимум.
Искусственный интеллект и нейросеть — одно и то же?
Нет. Нейросеть — тип модели. ИИ включает ещё шахматный перебор, системы вроде MYCIN и классические алгоритмы обучения без слоёв «нейронов».
С чего началась история ИИ?
Публично — со статьи Тьюринга 1950 года и Дартмутского семинара 1956 года, к которому придумали само название. Практические корни — в игровых программах и логике 1950-х, вроде шашек Сэмюэла и Logic Theorist.
Что такое зима ИИ?
Период, когда интерес и финансирование резко падали после завышенных обещаний. Обычно выделяют две: примерно 1974–1980 и 1987–2000 годы.
Зачем студенту пробовать чат, если есть учебник?
Чтобы увидеть типичные ошибки моделей: подмену дат, исчезновение символьных методов, уверенный тон без источника. Сверка с первичными ссылками тренирует критичность, которую экзамен всё равно потребует.
Связанные модели


Связанные гайды
- Как выбрать модель
Какую модель взять: текст или картинки, быстрая модель или флагман. Короткая схема выбора и примеры под код, письма и разбор.
- Как писать промпты
Базовая схема промпта в GPThub: роль, задача, формат ответа и запреты. Готовые шаблоны и типичные ошибки — без воды.
Похожие статьи
- Нейросеть простыми словами
Нейросеть — программа, которая учится на примерах, а не по правилам. Объясняем простыми словами, как она работает, что такое модель и запрос.
- Машинное обучение
Что такое машинное обучение простыми словами, чем оно не похоже на нейросеть и как проверять ответы больших моделей в чате.
- Что такое большая языковая модель
Большая языковая модель учится угадывать следующее слово и из этого получается текст. Разбираем токены, окно контекста и отличие модели от чата.
- Генеративный ИИ
Генеративный искусственный интеллект создаёт новый текст и картинки по запросу. Чем он не похож на нейросеть, которая лишь выбирает метку.
- Что такое ИИ-ассистент
ИИ-ассистент отвечает на запросы и помогает с текстом, планами и файлами. Чем он отличается от поиска и агента и что проверять в ответе.
- Точный вопрос нейросети
Как задать вопрос нейросети, чтобы ответ был точным: контекст, источник фактов, право на «не знаю», когда включать поиск и как проверить ответ.
Источники
- IBM Think — What is artificial intelligence?
- IBM History — Deep Blue
- Deep Blue versus Garry Kasparov — Wikipedia
- A Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, 1955
- Turing test — Stanford Encyclopedia of Philosophy
- Logic Theorist — Wikipedia
- ELIZA — Wikipedia
- MYCIN — Wikipedia
- AI winter — Wikipedia
- AlexNet — Wikipedia
- AlphaGo — Wikipedia
- Turing Award 2018: Bengio, Hinton, LeCun — ACM
- Jones, Bergen. Large Language Models Pass the Turing Test, 2025 — arXiv
Об авторе
Обозреватель: как устроен ИИ
Объясняет, как устроены нейросети и почему они ошибаются.
Открыть чат
Доступ из России без VPN. Модели, гайды и тарифы — в одном продукте.